Beginnen wir mit der Tatsache, die die Hälfte aller Annahmen über dieses Tag umstößt: rel="canonical" ist ein Hinweis, kein Befehl.
Google wägt ihn gegen alle anderen Signale ab — interne Verlinkung, Sitemap, Weiterleitungen, hreflang. Widersprechen sich diese Signale, wählt die Suchmaschine die URL, die sie für richtig hält, und ignoriert Ihr Canonical. So steht es in Googles eigener Dokumentation zur Konsolidierung doppelter URLs.
Alles Weitere folgt daraus: Canonical wirkt nicht für sich allein, sondern nur, wenn die übrigen Signale in dieselbe Richtung zeigen.
Syntax
Das Tag gehört in den <head>:
<link rel="canonical" href="https://example.com/seite">
Drei Regeln, gegen die am häufigsten verstoßen wird:
Absolute URL verwenden. Relative Pfade sind technisch erlaubt, aber jeder Fehler in der Basis-URL macht sie wertlos. Schreiben Sie sie vollständig aus, samt Schema und Host.
Genau ein Tag. Zwei unterschiedliche Canonical-Angaben auf einer Seite, und Google verwirft beide. Das ist das klassische Ergebnis zweier gleichzeitig aktiver SEO-Plugins.
Nur im <head>. Ein Canonical, das im <body> landet — etwa von einem Skript an der falschen Stelle eingefügt —, wird nicht berücksichtigt.
Für Dateien ohne eigenes HTML (PDF, Bilder) wird das Canonical als HTTP-Header übertragen:
Link: <https://example.com/dokument.pdf>; rel="canonical"
Was Canonical löst
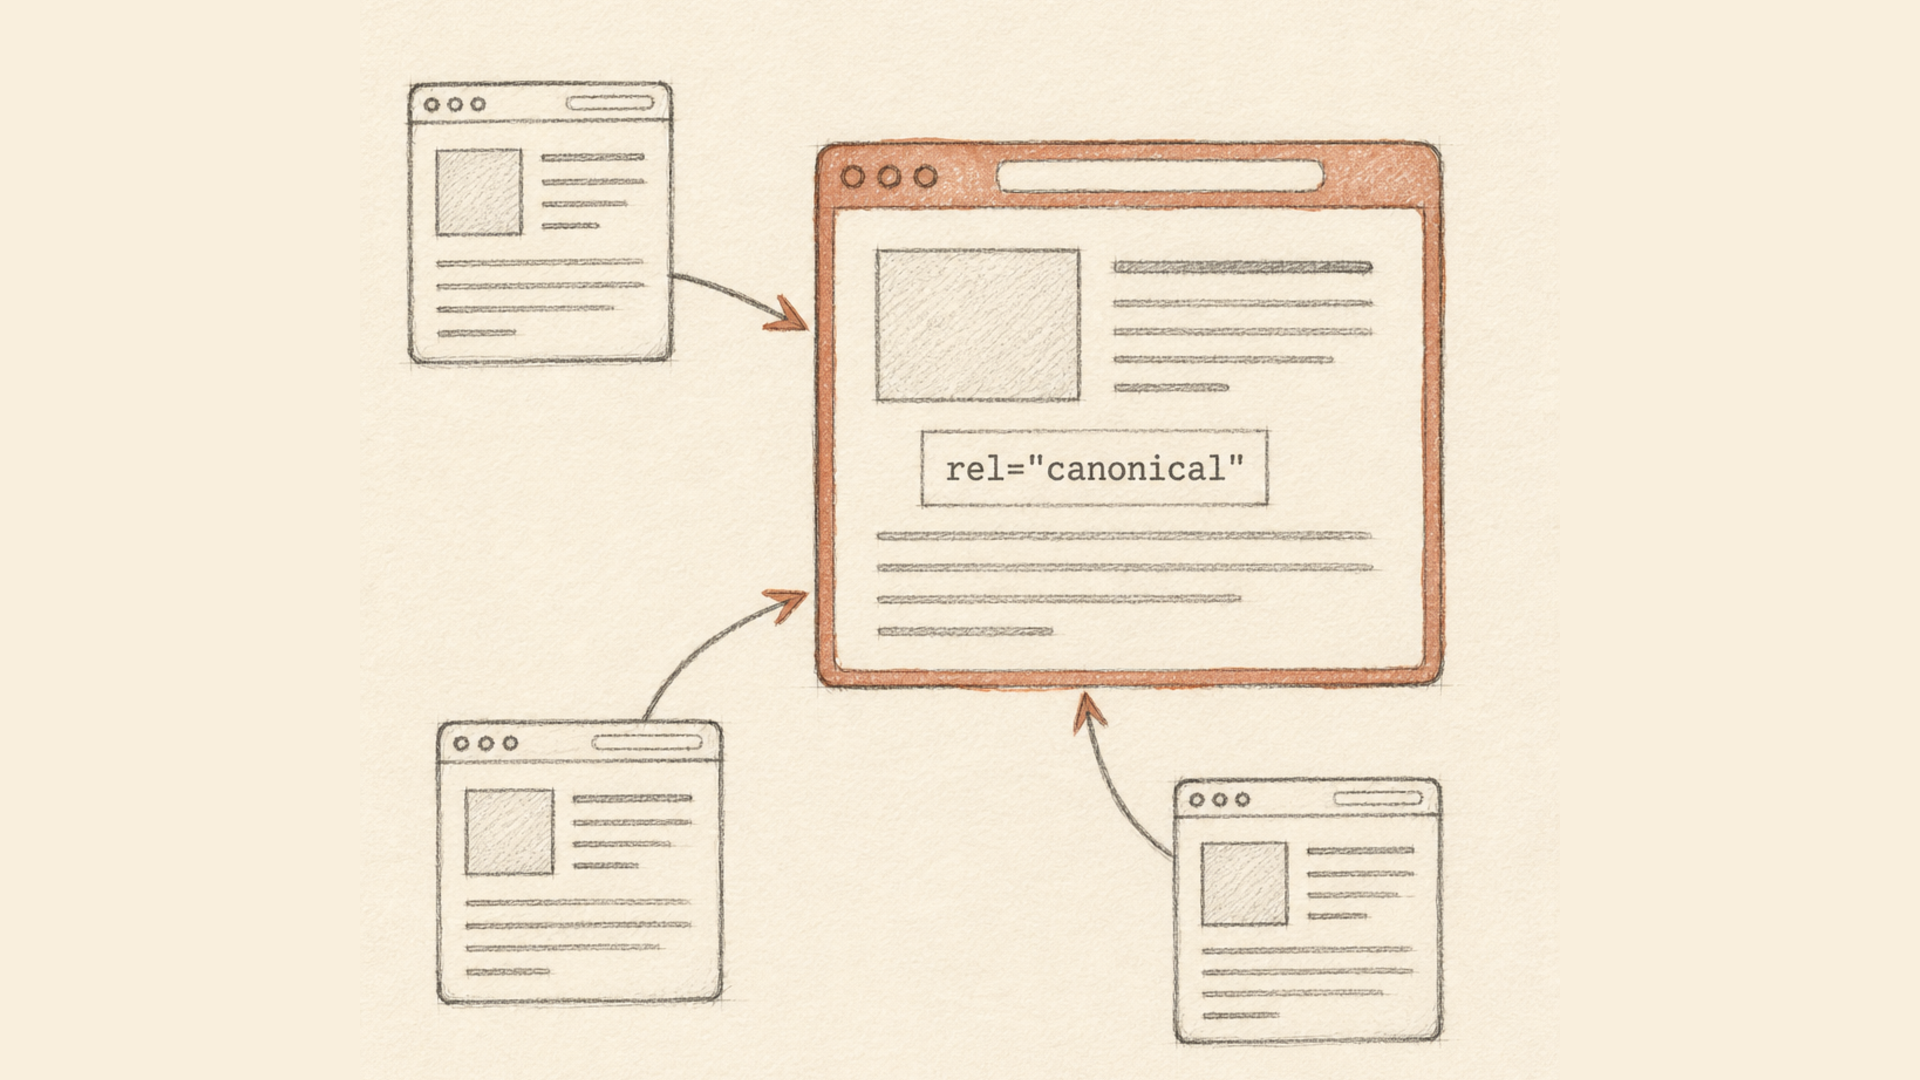
Genau ein Problem: derselbe Inhalt liegt unter mehreren URLs, und alle müssen erreichbar bleiben.
Typische Fälle:
- Sortier- und Filterparameter:
?sort=price,?color=red; - UTM-Parameter und Werbe-IDs;
- ein Produkt in mehreren Kategorien;
- Druckansichten;
- dasselbe Material auf verschiedenen Subdomains.
In keinem dieser Fälle können Sie einfach weiterleiten — die Seite wird gebraucht. Canonical sagt der Suchmaschine, welche Adresse als primär gilt, und bündelt die Signale dort.
Selbstreferenzierendes Canonical
Eine Seite darf ihr Canonical auf sich selbst richten. Nicht zwingend, aber nützlich: Es schützt davor, dass jemand Ihre URL mit einem angehängten Fremdparameter aufruft und die Suchmaschine daraus eine eigene Seite macht.
Was Canonical nicht ist
Hier passieren die meisten Fehler, deshalb die benachbarten Werkzeuge in einer Tabelle.
| Ziel | Werkzeug | Warum nicht Canonical |
|---|---|---|
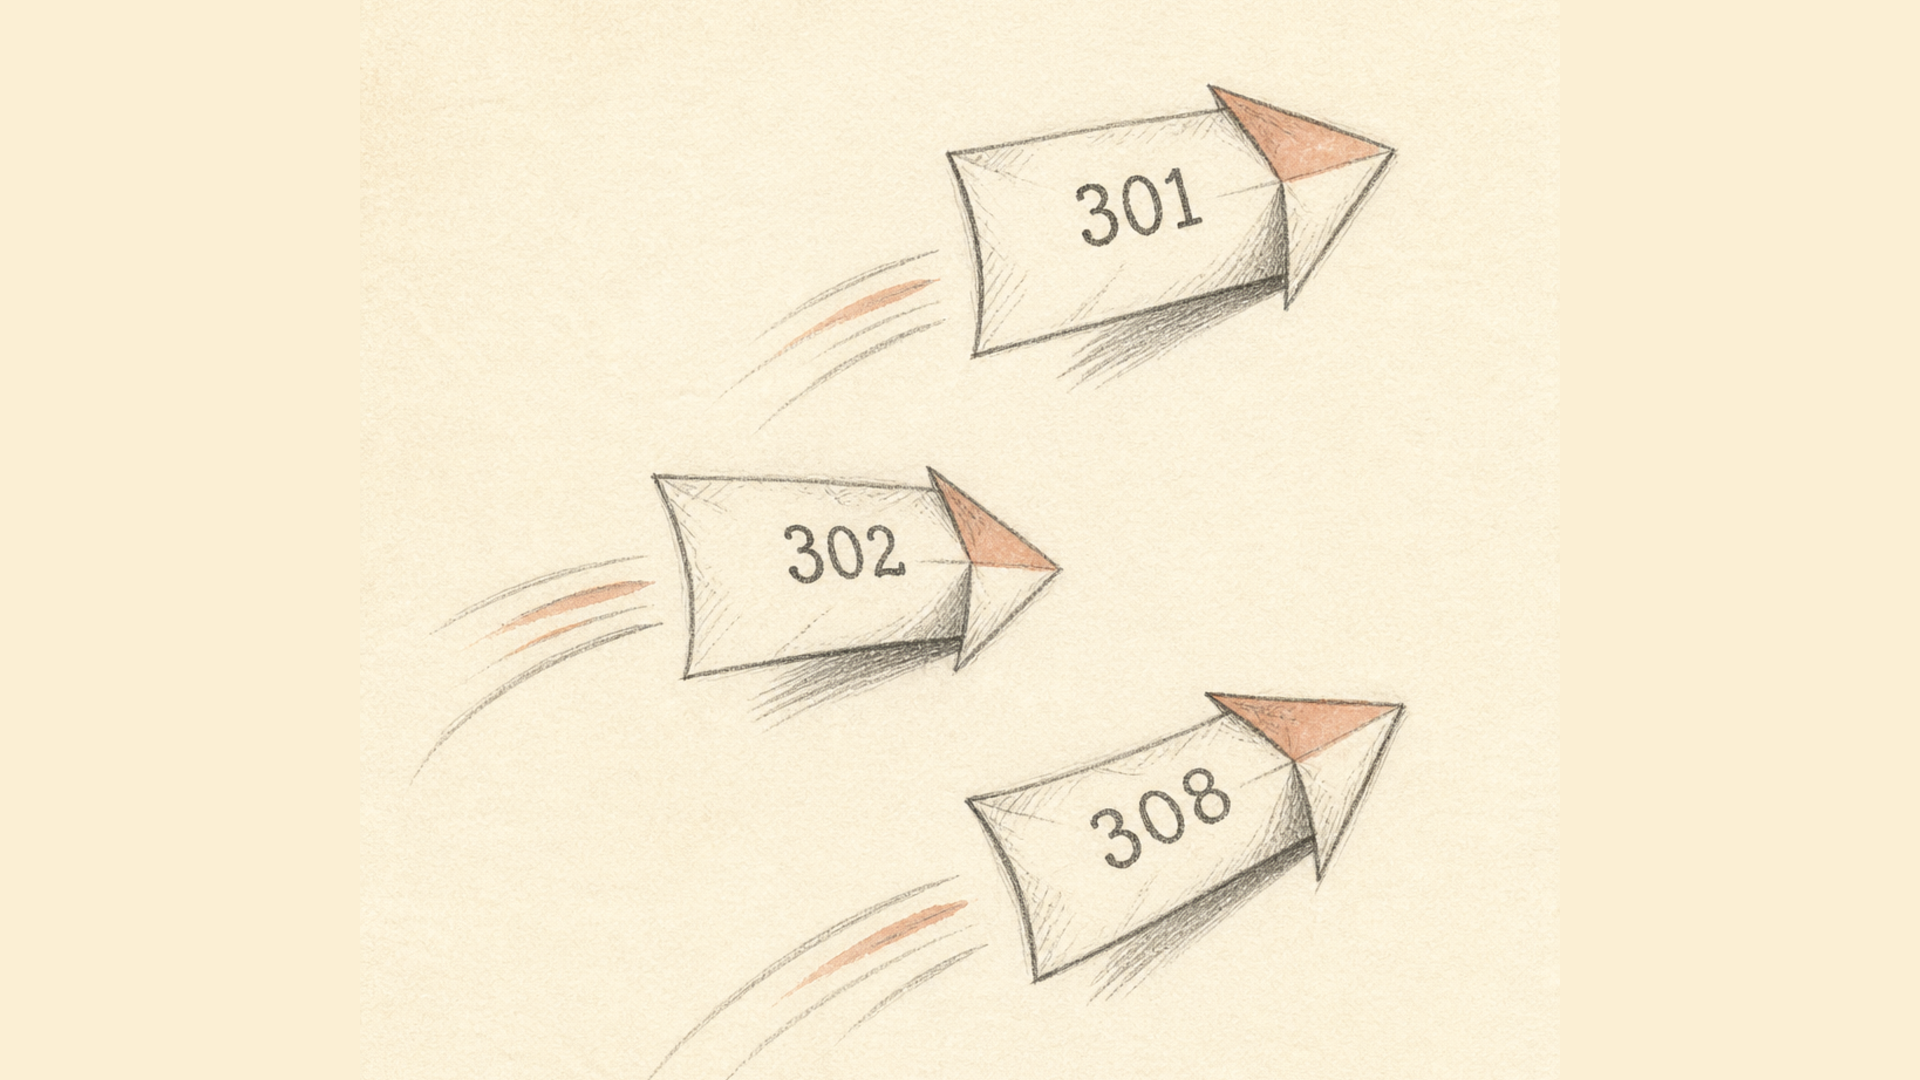
| Seite ist dauerhaft umgezogen | 301-Weiterleitung | Canonical lässt die alte URL erreichbar |
| Ziel ändert sich vorübergehend | 302-Weiterleitung | Gleicher Grund |
| Seite darf nicht im Index sein | noindex |
Canonical entfernt nichts aus dem Index |
| Seite soll nicht gecrawlt werden | robots.txt | Was sie ebenfalls nicht aus dem Index nimmt |
| Gleicher Inhalt in mehreren Sprachen | hreflang + Selbst-Canonical | Das sind keine Duplikate |
| Paginierte Listen | Nichts | Die Seiten 2, 3, 4 stehen für sich |
Zwei Punkte verdienen Nachdruck.
Canonical ersetzt kein 301. Ist eine Seite tatsächlich umgezogen, leiten Sie weiter. Canonical ist für Fälle, in denen beide URLs weiter funktionieren müssen.
Paginierung ist keine Duplizierung. Das Canonical aller Listenseiten auf Seite eins zu richten ist ein verbreiteter Fehler: Die Inhalte der Seiten 2 und 3 unterscheiden sich, und Sie nehmen sie damit schlicht aus dem Index.
Canonical und hreflang
Der heikelste Teil — und hier wohnt der teuerste Fehler dieses Themengebiets.
Der Fehler: alle Sprachversionen auf die englische zu canonicalisieren. Die Logik wirkt einleuchtend, Englisch sei die „Hauptversion". Das Ergebnis ist das Gegenteil: Sie teilen der Suchmaschine mit, dass die deutsche und die spanische Seite nicht eigenständig sind, und sie verschwinden aus den Ergebnissen ihrer eigenen Märkte.
Die richtige Anordnung:
- jede Sprachversion richtet ihr Canonical auf sich selbst;
- alle Versionen führen einander per
hreflangauf, sich selbst eingeschlossen; - die Beziehungen sind wechselseitig: verweist A auf B, muss B auf A verweisen;
hreflangzeigt auf kanonische URLs, nicht auf Varianten mit Parametern;x-defaultbenennt die Rückfallversion für Besucher, deren Sprache zu keiner passt.
So ist die Website aufgebaut, die Sie gerade lesen. Die Seite zum Kürzen von YouTube-Links existiert in 21 Sprachversionen, und jede canonicalisiert auf sich selbst. Die chinesische sieht so aus:
<link rel="canonical" href="https://lix.li/suoduan-youtube-lianjie">
<link rel="alternate" hreflang="en" href="https://lix.li/shorten-youtube-link">
<link rel="alternate" hreflang="zh" href="https://lix.li/suoduan-youtube-lianjie">
<link rel="alternate" hreflang="es" href="https://lix.li/acortar-link-youtube">
Beachten Sie: Das Canonical zeigt auf die chinesische URL, nicht auf die englische, und die chinesische Version steht in ihrer eigenen hreflang-Liste.
Häufige Fehler
Google hat die wichtigsten schon vor Jahren in seinem Beitrag zu fünf Fehlern mit rel=canonical gesammelt, und die Liste hat sich seither kaum geändert.
Canonical zeigt auf eine URL, die 404 liefert. Das Tag wird vollständig ignoriert.
Canonical zeigt auf eine Seite mit noindex. Widersprüchliche Signale: Sie sagen gleichzeitig „behandle diese als primär" und „indexiere sie nicht".
Canonical zeigt auf eine in robots.txt gesperrte URL. Der Crawler kann sie nicht abrufen und daher auch nicht bestätigen.
Ketten. A zeigt auf B, B zeigt auf C. In der Search Console wird daraus „Keine kanonische URL ausgewählt". Zeigen Sie direkt auf die endgültige URL.
http mit https, www mit Nicht-www vermischen. Schema und Host im Canonical müssen zu der Version passen, die Sie als primär führen.
Canonical und noindex auf derselben Seite. Entscheiden Sie sich für eines.
Wenn Google eine andere URL wählt
In der Search Console erscheint das als „Duplikat – Google hat eine andere Seite als kanonisch bestimmt als der Nutzer".
Das ist weder ein Markup-Fehler noch eine Strafe. Es ist die Mitteilung, dass die übrigen Signale Ihr Tag überstimmt haben. Was zu prüfen ist:
- Interne Links. Verlinkt die gesamte Website die Parameter-Variante, während das Canonical auf die saubere URL zeigt, glaubt die Suchmaschine den Links.
- Die Sitemap. Sie sollte ausschließlich kanonische URLs enthalten.
- Weiterleitungen. Zeigt das Canonical auf eine URL, die selbst weiterleitet, verliert das Tag seine Wirkung.
- Ob es wirklich Duplikate sind. Unterscheidet sich der Inhalt spürbar, behandelt die Suchmaschine die Seiten zu Recht als verschieden.
Bringen Sie die Signale in Einklang, dann wirkt auch das Tag. Mit dem Algorithmus zu streiten ist zwecklos; er liest das Gesamtbild.
Kurzlinks und Canonical
Eine Frage, die oft gestellt wird und die allgemeine Leitfäden nicht beantworten.
Erzeugt ein Kurzlink ein Duplikat der Seite? Nein.
Ein Kürzungsdienst liefert keine Kopie des Inhalts — er gibt eine HTTP-Weiterleitung zurück. Eine 302-Antwort hat weder Body noch <head>, es gibt also physisch keinen Ort für ein Canonical. Der Crawler folgt der Weiterleitung und arbeitet mit dem Ziel, das sein eigenes Canonical trägt. Wie dieser Mechanismus funktioniert, steht in wie funktionieren Link-Verkürzer.
Kurzlinks auf dieser Website senden zusätzlich den Header X-Robots-Tag: noindex, nofollow und bitten damit ausdrücklich, die Weiterleitung selbst nicht zu indexieren.
Und eine eigene Kurzdomain? Auch sie erzeugt keine Duplikate, solange sie weiterleitet. Duplikate entstehen, wenn Sie identische Inhalte auf zwei Domains ausliefern, ohne weiterzuleiten — genau dann brauchen Sie ein Canonical auf die primäre. Warum sich eine individuelle Domain für Kurzlinks lohnt, steht gesondert, und einrichten lässt sie sich auf der Seite zur eigenen Domain.
Kurze Checkliste
- Ein Canonical pro Seite, im
<head>, absolute URL. - Das Ziel liefert 200, ist nicht in robots.txt gesperrt und nicht mit
noindexversehen. - Keine Ketten — direkt auf die endgültige URL zeigen.
- Jede Sprachversion canonicalisiert auf sich selbst; hreflang wechselseitig.
- Sitemap und interne Links führen auf dieselben kanonischen URLs.
- Paginierung und umgezogene Seiten werden mit eigenen Mitteln gelöst, nicht mit Canonical.