Commençons par le fait qui renverse la moitié des idées reçues sur cette balise : rel="canonical" est une indication, pas un ordre.
Google la met en balance avec tous les autres signaux — liens internes, sitemap, redirections, hreflang. Lorsque ces signaux se contredisent, le moteur choisit l'URL qu'il juge correcte et ignore votre canonical. C'est écrit dans la documentation officielle de Google sur la consolidation des doublons.
Tout le reste en découle : le canonical n'agit pas seul, mais seulement lorsque les autres signaux pointent dans la même direction.
Syntaxe
La balise se place dans le <head> :
<link rel="canonical" href="https://example.com/page">
Trois règles enfreintes plus souvent que les autres :
URL absolue. Les chemins relatifs sont techniquement autorisés, mais la moindre erreur dans l'URL de base les rend inutilisables. Écrivez-la en entier, protocole et hôte compris.
Exactement une balise. Deux liens canonical différents sur une page, et Google écarte les deux. C'est le résultat classique de deux extensions SEO actives en même temps.
Uniquement dans le <head>. Un canonical qui se retrouve dans le <body> — injecté par un script au mauvais endroit, par exemple — n'est pas pris en compte.
Pour les fichiers sans HTML propre (PDF, images), le canonical passe par un en-tête HTTP :
Link: <https://example.com/document.pdf>; rel="canonical"
Ce que le canonical résout
Un seul problème : le même contenu existe à plusieurs URL, et toutes doivent rester accessibles.
Cas typiques :
- paramètres de tri et de filtre :
?sort=price,?color=red; - balises UTM et identifiants publicitaires ;
- un produit rangé dans plusieurs catégories ;
- versions imprimables ;
- le même contenu sur des sous-domaines différents.
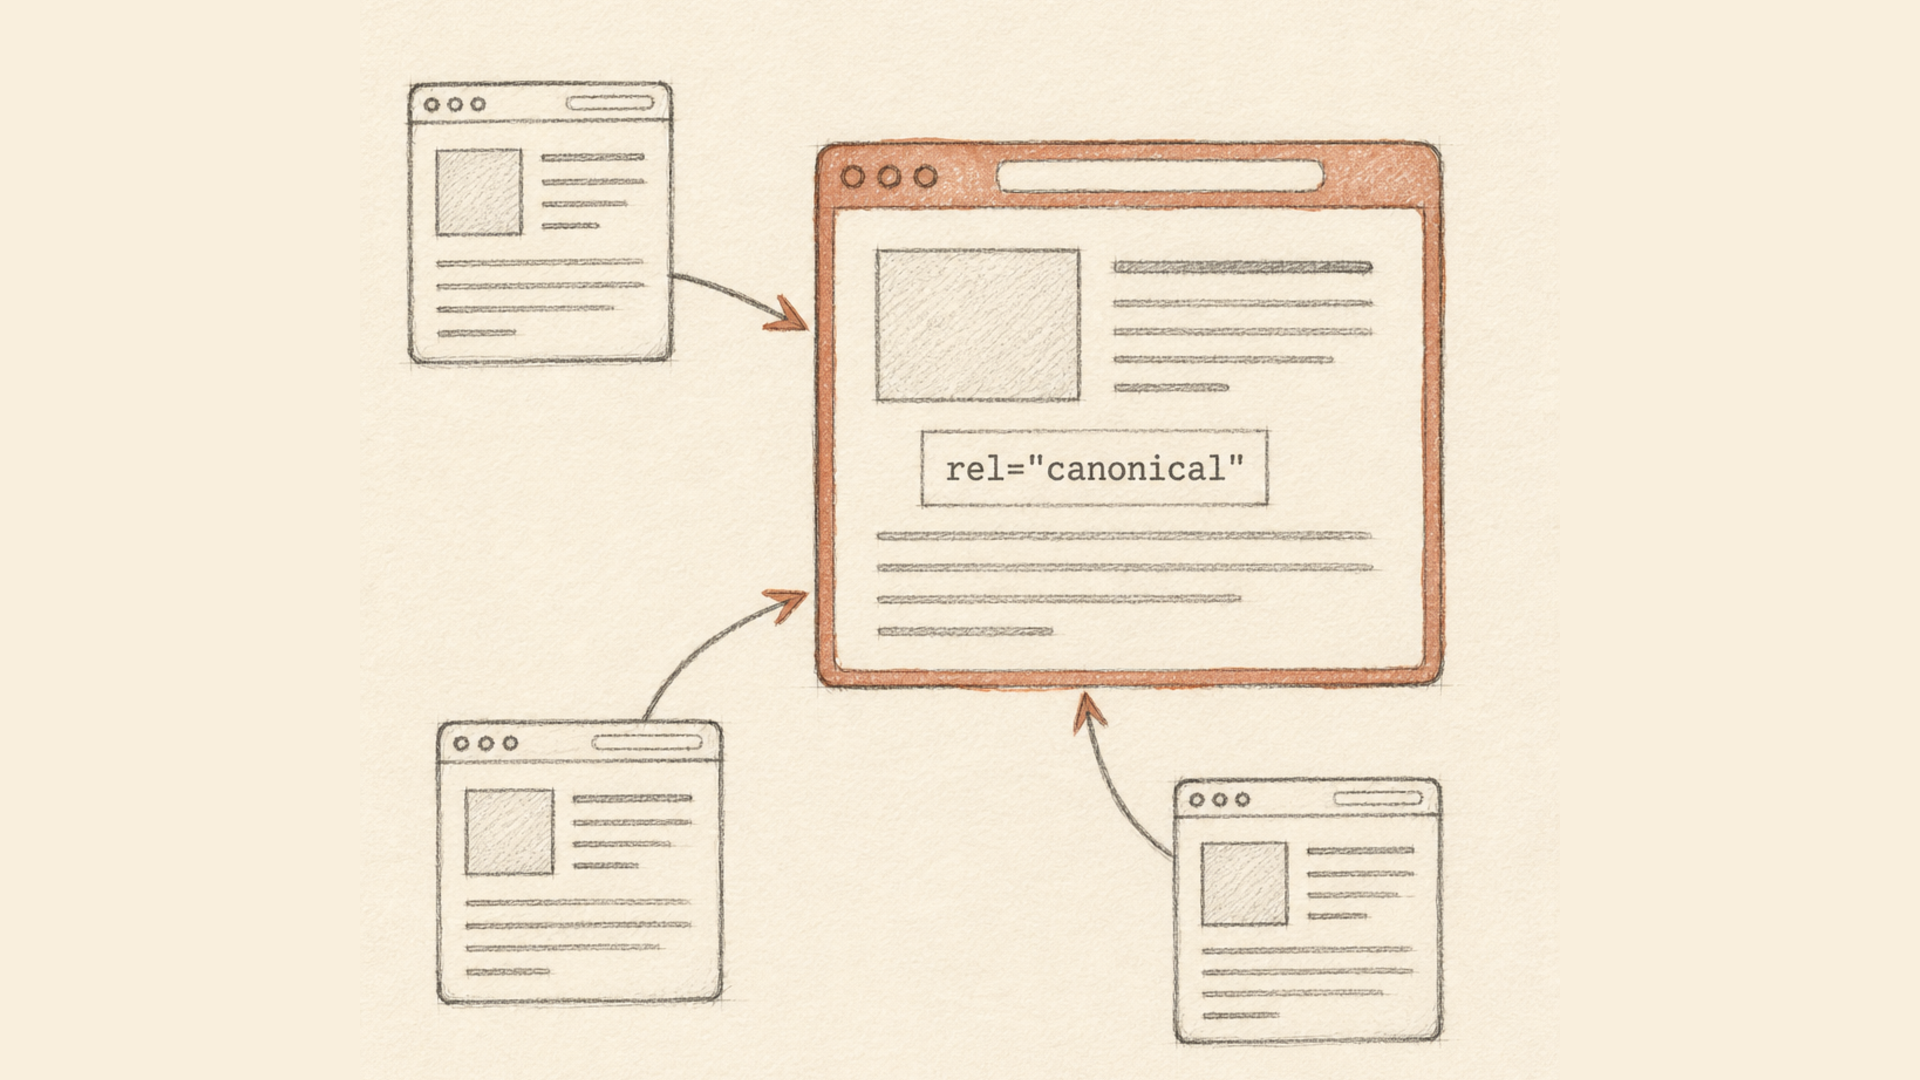
Dans aucun de ces cas vous ne pouvez simplement rediriger : la page est nécessaire. Le canonical indique au moteur quelle adresse considérer comme principale et y regroupe les signaux.
Canonical auto-référent
Une page peut pointer son canonical vers elle-même. Ce n'est pas obligatoire, mais c'est utile : cela vous protège si quelqu'un ouvre votre URL avec un paramètre étranger ajouté et que le moteur y voit une page distincte.
Ce que le canonical n'est pas
C'est ici que se logent la plupart des erreurs ; voici donc les outils voisins dans un tableau.
| Objectif | Outil | Pourquoi pas le canonical |
|---|---|---|
| La page a déménagé définitivement | Redirection 301 | Le canonical laisse l'ancienne URL accessible |
| La destination change temporairement | Redirection 302 | Même raison |
| La page ne doit pas être indexée | noindex |
Le canonical ne retire rien de l'index |
| La page ne doit pas être explorée | robots.txt | Ce qui ne la retire pas non plus de l'index |
| Même contenu en plusieurs langues | hreflang + canonical auto-référent | Ce ne sont pas des doublons |
| Listes paginées | Rien | Les pages 2, 3, 4 existent par elles-mêmes |
Deux points méritent d'être soulignés.
Le canonical ne remplace pas un 301. Si la page a réellement déménagé, redirigez. Le canonical sert quand les deux URL doivent continuer de fonctionner.
La pagination n'est pas de la duplication. Pointer le canonical de toutes les pages de liste vers la première est une erreur courante : le contenu des pages 2 et 3 diffère, et vous ne faites que le retirer de l'index.
Canonical et hreflang
La partie la plus délicate, et le lieu de l'erreur la plus coûteuse du domaine.
L'erreur : canonicaliser toutes les versions linguistiques vers l'anglaise. La logique paraît raisonnable — l'anglais serait la version « principale ». Le résultat est inverse : vous indiquez au moteur que les pages allemande et espagnole ne sont pas autonomes, et elles disparaissent des résultats sur leurs propres marchés.
Le schéma correct :
- chaque version linguistique pointe son canonical vers elle-même ;
- toutes les versions se listent mutuellement via
hreflang, y compris elles-mêmes ; - les relations sont réciproques : si A référence B, B doit référencer A ;
hreflangpointe vers des URL canoniques, pas vers des variantes paramétrées ;x-defaultdésigne la version de repli pour les visiteurs dont la langue ne correspond à aucune.
C'est ainsi qu'est construit le site que vous lisez. La page consacrée au raccourcissement des liens YouTube existe en 21 versions linguistiques, et chacune se canonicalise vers elle-même. La version chinoise ressemble à ceci :
<link rel="canonical" href="https://lix.li/suoduan-youtube-lianjie">
<link rel="alternate" hreflang="en" href="https://lix.li/shorten-youtube-link">
<link rel="alternate" hreflang="zh" href="https://lix.li/suoduan-youtube-lianjie">
<link rel="alternate" hreflang="es" href="https://lix.li/acortar-link-youtube">
Remarquez que le canonical pointe vers l'URL chinoise et non vers l'anglaise, et que la version chinoise figure dans sa propre liste hreflang.
Erreurs fréquentes
Google a recensé les principales il y a des années dans sa note sur cinq erreurs avec rel=canonical, et la liste n'a presque pas bougé depuis.
Canonical pointant vers une URL qui renvoie 404. La balise est ignorée entièrement.
Canonical pointant vers une page en noindex. Signaux contradictoires : vous dites à la fois « traite celle-ci comme principale » et « ne l'indexe pas ».
Canonical pointant vers une URL bloquée dans robots.txt. Le robot ne peut pas la récupérer, donc pas la confirmer non plus.
Chaînes. A pointe vers B, B pointe vers C. Dans la Search Console cela devient « URL canonique non sélectionnée ». Pointez directement vers l'URL finale.
Mélanger http et https, www et sans-www. Le protocole et l'hôte du canonical doivent correspondre à la version que vous considérez comme principale.
Canonical et noindex sur la même page. Choisissez l'un des deux.
Quand Google choisit une autre URL
Dans la Search Console, cela apparaît comme « Page en double, Google n'a pas sélectionné la même page canonique que l'utilisateur ».
Ce n'est ni une erreur de balisage ni une sanction. C'est un message indiquant que les autres signaux ont pesé plus lourd que votre balise. À vérifier :
- Les liens internes. Si tout le site pointe vers la variante paramétrée alors que le canonical vise l'URL propre, le moteur croit les liens.
- Le sitemap. Il ne doit contenir que des URL canoniques.
- Les redirections. Si le canonical vise une URL qui redirige elle-même, la balise perd sa force.
- S'il s'agit vraiment de doublons. Si le contenu diffère sensiblement, le moteur a raison de traiter les pages comme distinctes.
Alignez les signaux et la balise se met à fonctionner. Discuter avec l'algorithme ne sert à rien : il lit l'ensemble du tableau.
Liens raccourcis et canonical
Une question fréquente à laquelle les guides généraux ne répondent pas.
Un lien raccourci crée-t-il un doublon de la page ? Non.
Un raccourcisseur ne sert pas une copie du contenu : il renvoie une redirection HTTP. Une réponse 302 n'a ni corps ni <head>, il n'y a donc physiquement aucun endroit où placer un canonical. Le robot suit la redirection et travaille sur la destination, qui porte son propre canonical. Le fonctionnement de ce mécanisme est détaillé dans comment fonctionnent les raccourcisseurs de liens.
Les liens courts de ce site renvoient en outre l'en-tête X-Robots-Tag: noindex, nofollow, demandant explicitement que la redirection elle-même ne soit pas indexée.
Et un domaine court personnalisé ? Il ne crée pas non plus de doublons tant qu'il redirige. Les doublons apparaissent quand vous servez un contenu identique sur deux domaines sans redirection — c'est alors qu'il faut un canonical vers le domaine principal. Vous pouvez en connecter un sur la page dédiée au domaine personnalisé.
Aide-mémoire
- Un canonical par page, dans le
<head>, en URL absolue. - La cible renvoie 200, n'est pas bloquée dans robots.txt ni marquée
noindex. - Pas de chaînes — pointez directement vers l'URL finale.
- Chaque version linguistique se canonicalise vers elle-même ; hreflang réciproque.
- Sitemap et liens internes mènent aux mêmes URL canoniques.
- Pagination et pages déménagées se règlent avec leurs propres outils, pas avec le canonical.