Comecemos pelo fato que derruba metade das ideias sobre esta tag: rel="canonical" é uma sugestão, não uma ordem.
O Google a pondera junto com todos os outros sinais: links internos, sitemap, redirecionamentos, hreflang. Quando esses sinais se contradizem, o buscador escolhe a URL que considera correta e ignora o seu canonical. Isso está na documentação oficial do Google sobre consolidação de duplicatas.
Daí decorre todo o resto: canonical não funciona sozinho, apenas quando os demais sinais apontam para o mesmo lugar.
Sintaxe
A tag fica no <head>:
<link rel="canonical" href="https://example.com/pagina">
Três regras que são quebradas com mais frequência:
URL absoluta. Caminhos relativos são tecnicamente permitidos, mas qualquer erro na URL base os transforma em lixo. Escreva por extenso, com esquema e domínio.
Exatamente uma tag. Dois links canonical diferentes numa página e o Google descarta os dois. É o resultado clássico de rodar dois plugins de SEO ao mesmo tempo.
Somente dentro do <head>. Um canonical que acaba no <body> — injetado por um script no lugar errado, por exemplo — não é contado.
Para arquivos sem HTML próprio (PDF, imagens), o canonical viaja como cabeçalho HTTP:
Link: <https://example.com/documento.pdf>; rel="canonical"
O que o canonical resolve
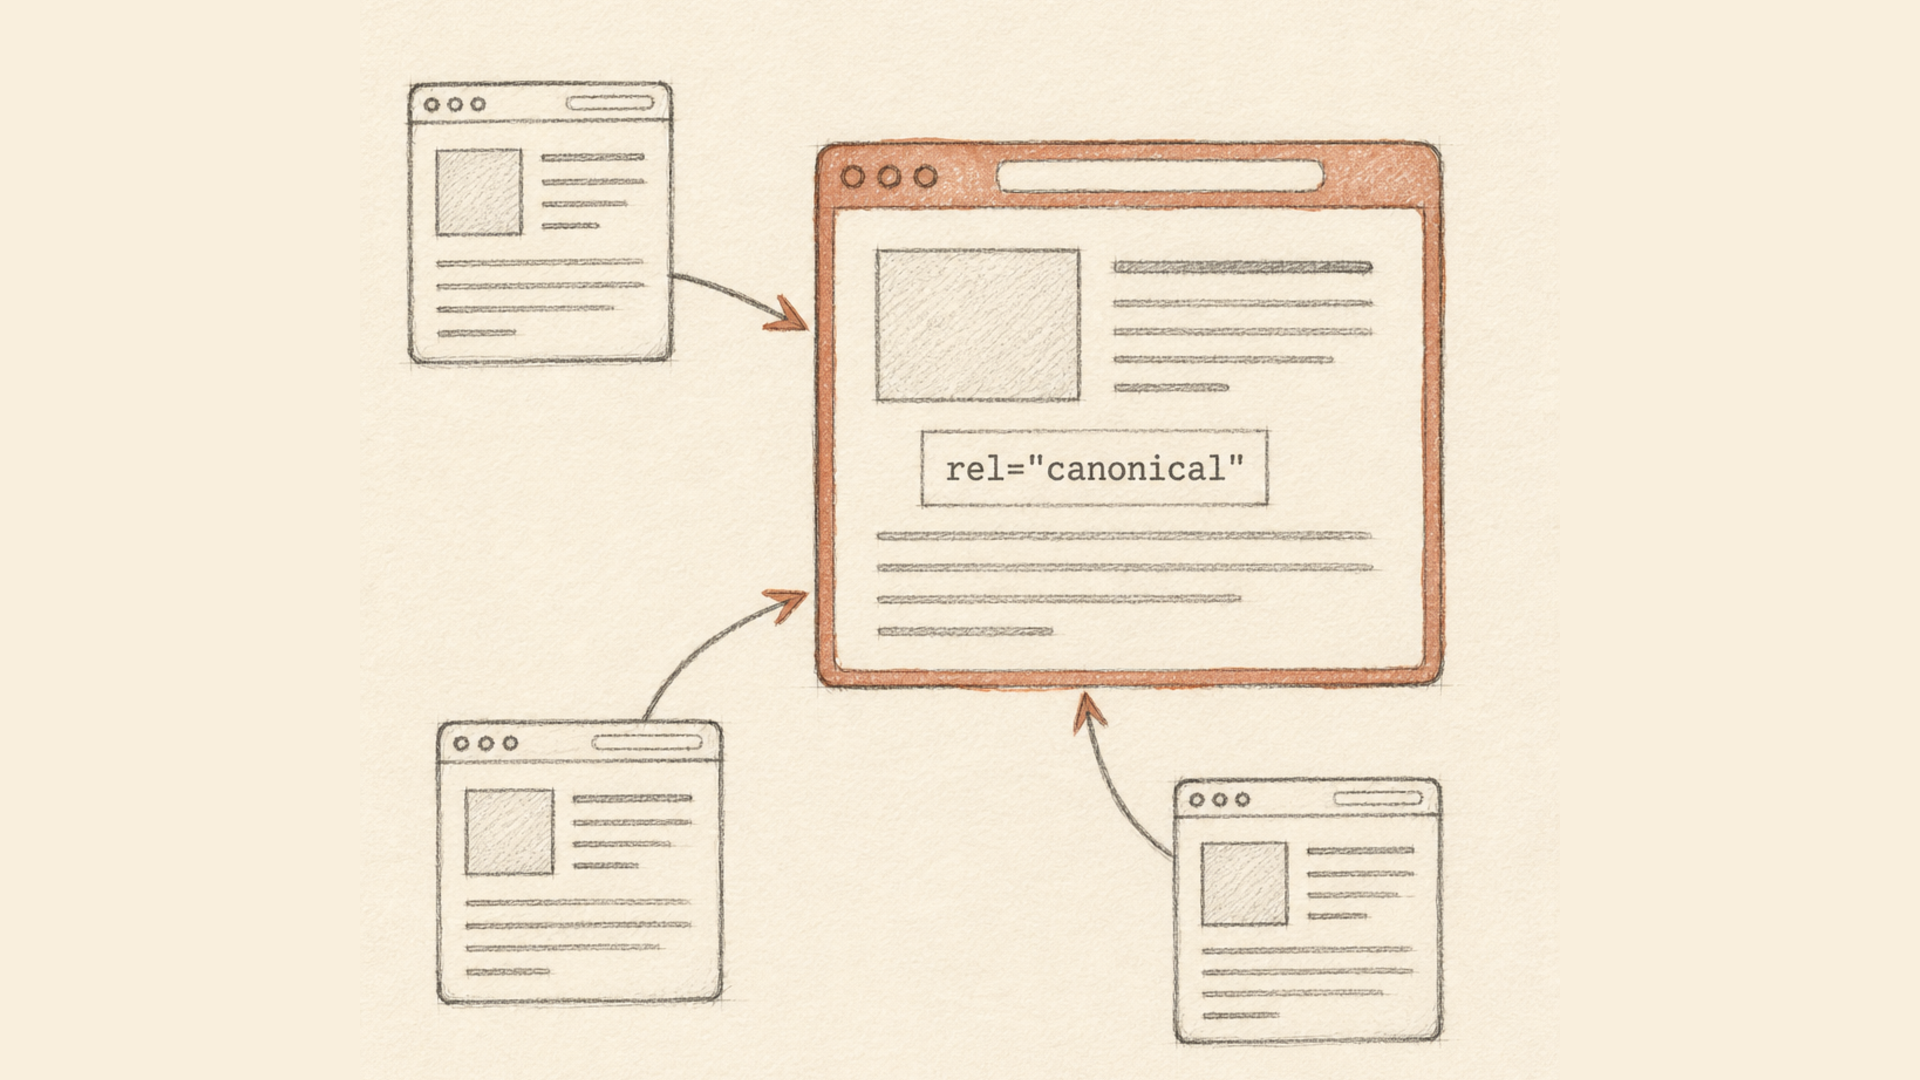
Um único problema: o mesmo conteúdo vive em várias URLs e todas precisam continuar acessíveis.
Casos típicos:
- parâmetros de ordenação e filtros:
?sort=price,?color=red; - tags UTM e identificadores de publicidade;
- um produto listado em várias categorias;
- versões para impressão;
- o mesmo material em subdomínios diferentes.
Em nenhum deles dá para simplesmente redirecionar: a página é necessária. O canonical diz ao buscador qual endereço tratar como principal e consolida os sinais nele.
Canonical para si mesmo
Uma página pode apontar seu canonical para ela mesma. Não é obrigatório, mas é útil: protege você de alguém abrir sua URL com um parâmetro solto no fim e o buscador tratar aquilo como página separada.
O que o canonical não é
É aqui que mora a maioria dos erros, então vejamos as ferramentas vizinhas numa tabela.
| Objetivo | Ferramenta | Por que não canonical |
|---|---|---|
| A página mudou definitivamente | Redirecionamento 301 | O canonical deixa a URL antiga acessível |
| O destino muda temporariamente | Redirecionamento 302 | Mesmo motivo |
| A página não deve estar no índice | noindex |
O canonical não remove nada do índice |
| A página não deve ser rastreada | robots.txt | Que também não a remove do índice |
| Mesmo conteúdo em vários idiomas | hreflang + canonical próprio | Não são duplicatas |
| Listagens paginadas | Nada | As páginas 2, 3, 4 são autônomas |
Dois itens merecem destaque.
Canonical não substitui um 301. Se a página realmente mudou, redirecione. O canonical é para quando as duas URLs precisam continuar funcionando.
Paginação não é duplicação. Apontar o canonical de todas as páginas da listagem para a primeira é um erro comum: o conteúdo das páginas 2 e 3 é diferente, e você simplesmente o está removendo do índice.
Canonical e hreflang
A parte mais delicada, e onde mora o erro mais caro desta área.
O erro: canonizar todas as versões de idioma para a inglesa. A lógica parece razoável — o inglês é a versão «principal». O resultado é o oposto: você diz ao buscador que as páginas alemã e espanhola não são independentes, e elas somem dos resultados nos próprios mercados.
O arranjo correto:
- cada versão de idioma aponta seu canonical para si mesma;
- todas as versões listam umas às outras via
hreflang, incluindo a si próprias; - as relações são recíprocas: se A referencia B, B precisa referenciar A;
- o
hreflangaponta para URLs canônicas, não para variantes com parâmetros; - o
x-defaultindica a versão de reserva para quem não se encaixa em nenhum idioma.
É assim que o site que você está lendo foi construído. A página sobre encurtar links do YouTube existe em 21 versões de idioma, e cada uma se canoniza para si mesma. A chinesa é assim:
<link rel="canonical" href="https://lix.li/suoduan-youtube-lianjie">
<link rel="alternate" hreflang="en" href="https://lix.li/shorten-youtube-link">
<link rel="alternate" hreflang="zh" href="https://lix.li/suoduan-youtube-lianjie">
<link rel="alternate" hreflang="es" href="https://lix.li/acortar-link-youtube">
Repare que o canonical aponta para a URL chinesa e não para a inglesa, e que a versão chinesa consta da sua própria lista de hreflang.
Erros frequentes
O Google catalogou os principais anos atrás na nota sobre cinco erros com rel=canonical, e a lista quase não mudou desde então.
Canonical apontando para uma URL que devolve 404. A tag é ignorada por inteiro.
Canonical apontando para uma página com noindex. Sinais contraditórios: você diz «trate esta como principal» e «não a indexe» ao mesmo tempo.
Canonical apontando para uma URL bloqueada no robots.txt. O rastreador não consegue buscá-la, portanto não consegue confirmá-la.
Cadeias. A aponta para B, B aponta para C. No Search Console isso vira «URL canônica não selecionada». Aponte direto para a URL final.
Misturar http com https, www com sem-www. O esquema e o host do canonical devem coincidir com a versão do site que você trata como principal.
Canonical e noindex na mesma página. Escolha um dos dois.
Quando o Google escolhe outra URL
No Search Console isso aparece como «Duplicada: o Google escolheu um canônico diferente do indicado pelo usuário».
Não é erro de marcação nem punição. É um aviso de que os demais sinais pesaram mais que a sua tag. O que verificar:
- Links internos. Se o site inteiro aponta para a variante com parâmetro enquanto o canonical aponta para a URL limpa, o buscador acredita nos links.
- O sitemap. Ele deve conter apenas URLs canônicas.
- Redirecionamentos. Se o canonical aponta para uma URL que por sua vez redireciona, a tag perde força.
- Se são mesmo duplicatas. Se o conteúdo difere de forma perceptível, o buscador faz bem em tratá-las como páginas distintas.
Alinhe os sinais e a tag passa a funcionar. Discutir com o algoritmo não adianta: ele lê o quadro inteiro.
Links curtos e canonical
Uma pergunta que aparece com frequência e que os guias gerais não respondem.
Um link encurtado cria uma duplicata da página? Não.
Um encurtador não serve uma cópia do conteúdo: ele devolve um redirecionamento HTTP. Uma resposta 302 não tem corpo nem <head>, então não há fisicamente onde colocar um canonical. O rastreador segue o redirecionamento e trabalha com o destino, que carrega o próprio canonical. Como esse mecanismo funciona está explicado em como funcionam os encurtadores de links.
Os links curtos deste site devolvem ainda o cabeçalho X-Robots-Tag: noindex, nofollow, pedindo explicitamente que o próprio redirecionamento não seja indexado.
E um domínio curto próprio? Também não cria duplicatas enquanto redirecionar. As duplicatas surgem quando você serve conteúdo idêntico em dois domínios sem redirecionar — aí sim é preciso um canonical apontando para o principal. Por que vale ter um domínio próprio para links curtos está tratado à parte, e você pode conectar um na página de domínio próprio.
Checklist
- Um canonical por página, dentro do
<head>, com URL absoluta. - O destino devolve 200, não está bloqueado no robots.txt nem marcado como
noindex. - Sem cadeias: aponte direto para a URL final.
- Cada versão de idioma se canoniza para si mesma; hreflang recíproco.
- Sitemap e links internos levam às mesmas URLs canônicas.
- Paginação e páginas mudadas se resolvem com ferramentas próprias, não com canonical.