先说一个能推翻大半认知的事实:rel="canonical" 是一条提示,而不是一道命令。
Google 会把它和其他所有信号放在一起权衡——内部链接、站点地图、跳转、hreflang。当这些信号彼此矛盾时,搜索引擎会选择它认为正确的网址,而忽略你的 canonical。这一点写在 Google 关于合并重复网址的官方文档里。
其余的一切都由此而来:canonical 无法独自生效,只有当其他信号指向同一处时它才起作用。
语法
标签放在 <head> 里:
<link rel="canonical" href="https://example.com/page">
最常被违反的三条规则:
使用绝对网址。 相对路径在技术上是允许的,但基准网址一旦出错,它们就变成垃圾。请连同协议和域名完整写出。
有且只有一个标签。 页面上出现两个不同的 canonical,Google 会把两个都丢弃。这是同时启用两个 SEO 插件的典型结果。
只能放在 <head> 内。 落到 <body> 里的 canonical——比如被脚本插错了位置——不会被计入。
对于没有自身 HTML 的文件(PDF、图片),canonical 通过 HTTP 响应头传递:
Link: <https://example.com/document.pdf>; rel="canonical"
canonical 解决什么
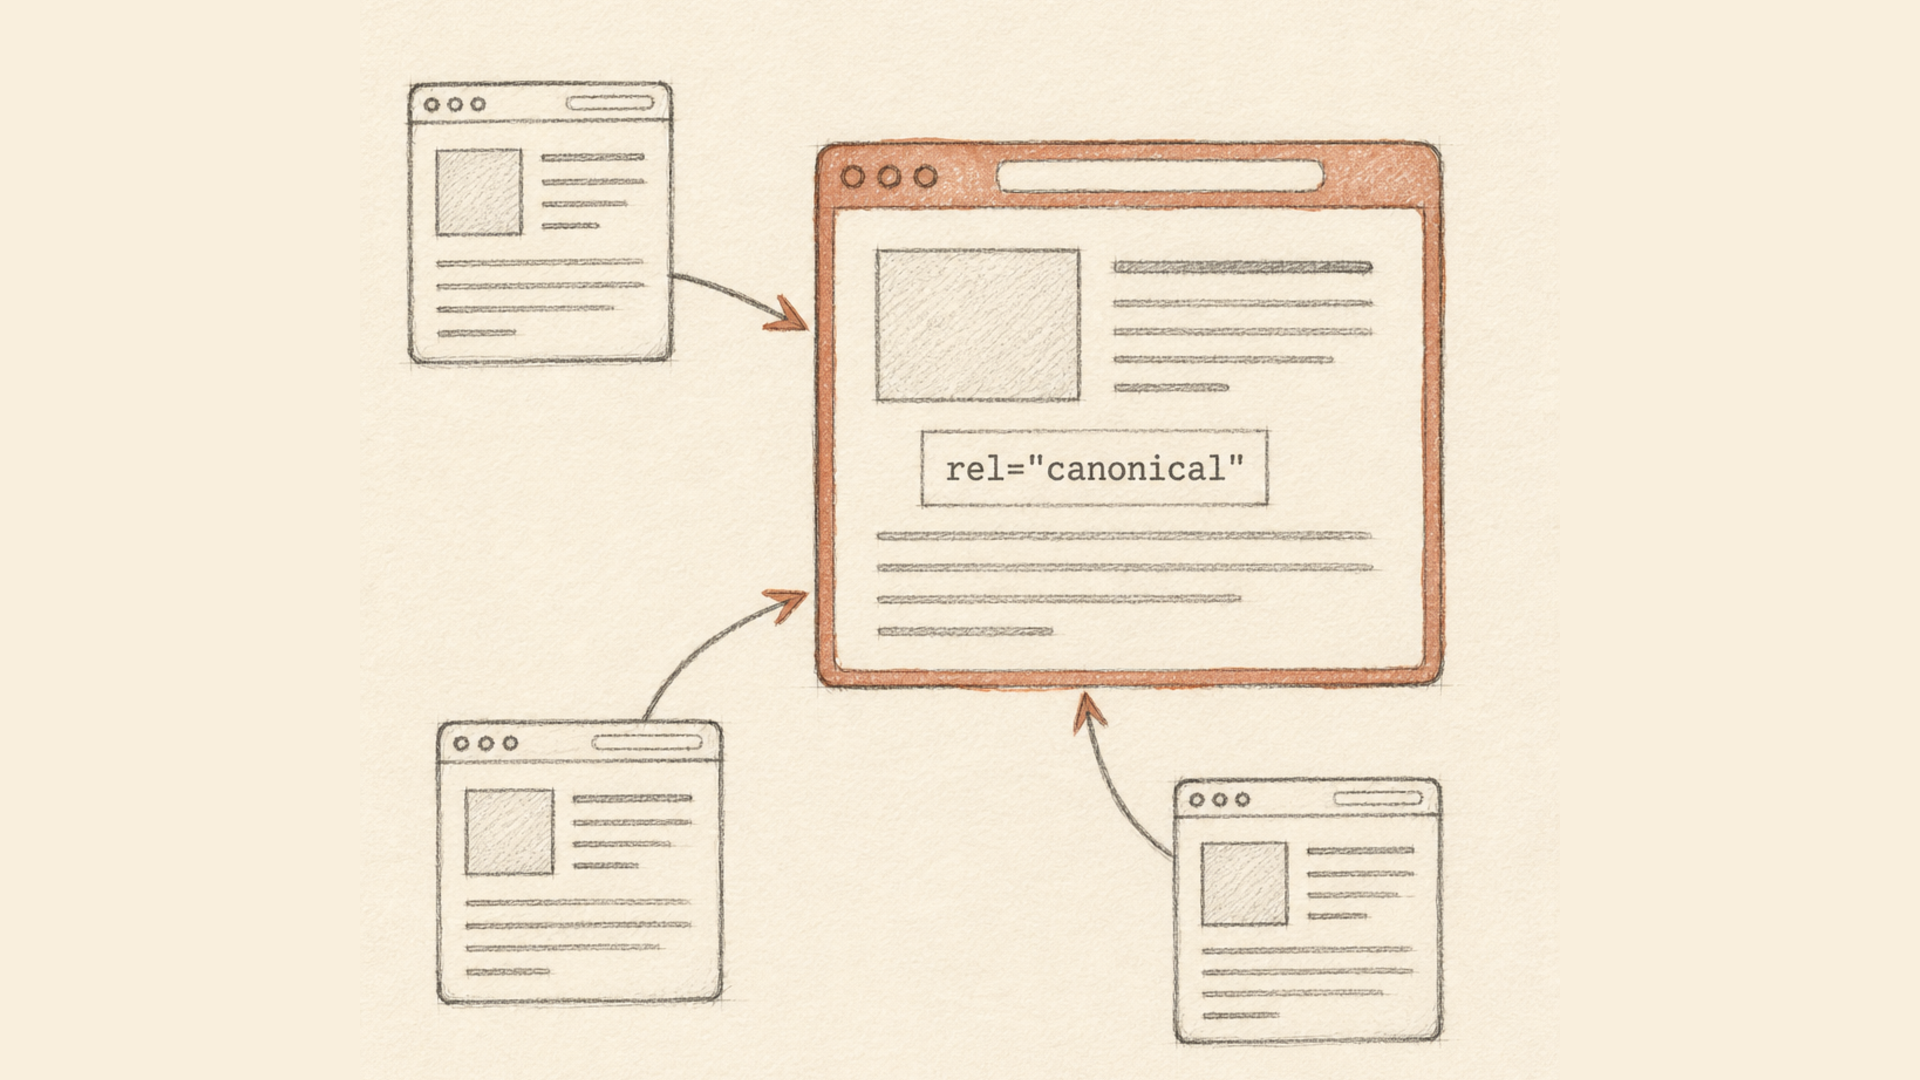
只解决一个问题:同一份内容存在于多个网址,而且这些网址都必须保持可访问。
典型情形:
- 排序与筛选参数:
?sort=price、?color=red; - UTM 标记与广告标识;
- 同一件商品挂在多个分类下;
- 打印版页面;
- 同一份材料位于不同子域名。
这些情形都不能简单地做跳转——页面本身是需要的。canonical 告诉搜索引擎把哪个地址当作主地址,并把信号汇集到它身上。
指向自身的 canonical
页面可以把 canonical 指向自己。这不是强制的,但很有用:它能防止有人在你的网址后面带上多余参数打开,而搜索引擎把它当成另一个页面。
canonical 不是什么
绝大多数错误都出在这里,所以把相邻的工具放进一张表。
| 目标 | 工具 | 为什么不是 canonical |
|---|---|---|
| 页面已永久迁移 | 301 跳转 | canonical 会让旧地址继续可访问 |
| 目标地址临时变更 | 302 跳转 | 同上 |
| 页面不应进入索引 | noindex |
canonical 不会从索引中移除任何东西 |
| 页面不应被抓取 | robots.txt | 但它同样不会把页面移出索引 |
| 同一内容的多语言版本 | hreflang + 指向自身的 canonical | 它们不是重复内容 |
| 分页列表 | 什么都不用 | 第 2、3、4 页各自独立 |
其中两条值得强调。
canonical 不能替代 301。 如果页面确实迁移了,就做跳转。canonical 适用于两个网址都必须继续工作的情形。
分页不是重复。 把列表所有分页的 canonical 都指向第一页是常见错误:第 2、3 页的内容并不相同,你只是把它们从索引里抹掉了。
canonical 与 hreflang
最微妙的部分,也是这个领域代价最高的错误所在。
这个错误就是:把所有语言版本都 canonical 到英文版。 这个逻辑听上去合理——英文是「主」版本。结果恰恰相反:你等于告诉搜索引擎德文页和西班牙文页不是独立页面,于是它们在各自市场的搜索结果中消失。
正确的做法:
- 每个语言版本把 canonical 指向自己;
- 所有版本通过
hreflang互相列出,包括列出自身; - 关系必须互相对应:如果 A 引用了 B,B 也必须引用 A;
hreflang指向的是规范网址,而不是带参数的变体;x-default指明语言都不匹配时的兜底版本。
你正在阅读的这个网站就是这样搭建的。关于缩短 YouTube 链接的页面有 21 个语言版本,每个都 canonical 到自身。中文版是这样的:
<link rel="canonical" href="https://lix.li/suoduan-youtube-lianjie">
<link rel="alternate" hreflang="en" href="https://lix.li/shorten-youtube-link">
<link rel="alternate" hreflang="zh" href="https://lix.li/suoduan-youtube-lianjie">
<link rel="alternate" hreflang="es" href="https://lix.li/acortar-link-youtube">
请注意:canonical 指向的是中文网址而非英文网址,而且中文版出现在它自己的 hreflang 列表里。
常见错误
Google 多年前就在《rel=canonical 的五个常见错误》中归纳过主要问题,这份清单至今几乎没有变化。
canonical 指向返回 404 的网址。 整个标签会被忽略。
canonical 指向带 noindex 的页面。 信号自相矛盾:你同时在说「把这个当主页面」和「不要索引它」。
canonical 指向被 robots.txt 屏蔽的网址。 抓取工具取不到它,也就无法确认它。
链式指向。 A 指向 B,B 指向 C。在 Search Console 中这会变成「未选定规范网址」。请直接指向最终网址。
混用 http 与 https、www 与非 www。 canonical 中的协议和主机必须与你视为主版本的站点一致。
同一页面上同时有 canonical 和 noindex。 二选一。
当 Google 选择了别的网址
在 Search Console 中,这显示为「重复网页,Google 选择的规范网页与用户指定的不同」。
这既不是标记错误,也不是惩罚。它是在告诉你:其他信号压过了你的标签。需要检查的是:
- 内部链接。 如果整站都链向带参数的变体,而 canonical 指向干净网址,搜索引擎会相信链接。
- 站点地图。 里面应当只有规范网址。
- 跳转。 如果 canonical 指向的网址本身又跳转到别处,标签就失去了效力。
- 它们是否真的是重复内容。 如果内容差异明显,搜索引擎把它们当作不同页面是合理的。
把信号理顺,标签自然会生效。和算法争辩没有意义,它读的是整幅图景。
短链接与 canonical
一个经常被问到、而通用指南不回答的问题。
短链接会制造页面重复吗?不会。
短链服务不提供内容副本——它返回的是 HTTP 跳转。302 响应没有正文也没有 <head>,因此在物理上就没有地方放 canonical。抓取工具跟随跳转,处理的是目标地址,而目标地址自带 canonical。这套机制的原理见短网服务是怎么工作的。
本站的短链接还会额外返回 X-Robots-Tag: noindex, nofollow 响应头,明确要求不要索引跳转本身。
那么自有短域名呢? 只要它做的是跳转,同样不会制造重复。重复出现在你把相同内容分别放在两个域名上而不做跳转的时候——那时才需要用 canonical 指向主域名。为什么值得拥有短链接的自定义域名另有讨论,绑定入口在自定义域名页面。
简短清单
- 每页一个 canonical,位于
<head>内,使用绝对网址。 - 目标返回 200,未被 robots.txt 屏蔽,也未标记
noindex。 - 不要链式指向——直接指向最终网址。
- 每个语言版本 canonical 到自身;hreflang 互相对应。
- 站点地图与内部链接指向同一批规范网址。
- 分页和已迁移页面用各自的工具解决,不要用 canonical。