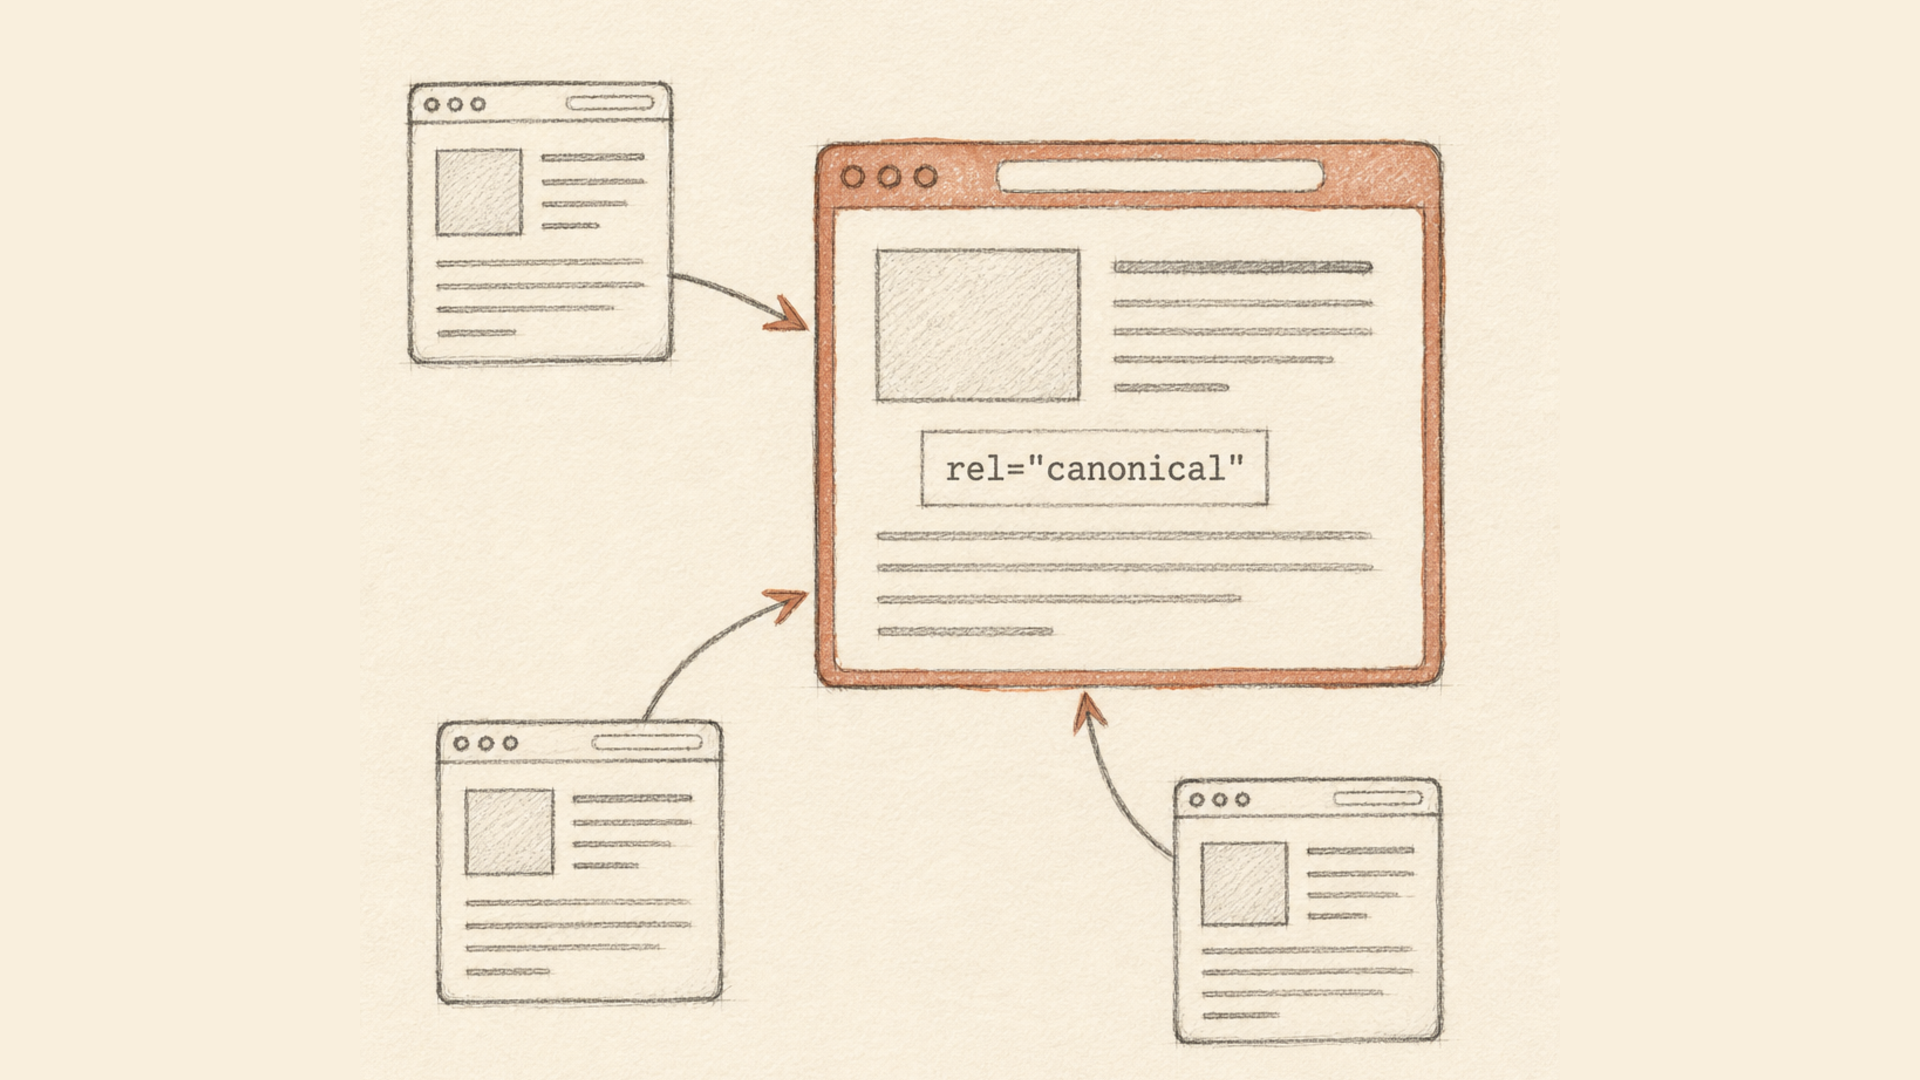
Начнём с того, что переворачивает половину представлений о теге: rel="canonical" — это подсказка, а не команда.
Google рассматривает его наравне с другими сигналами: внутренними ссылками, картой сайта, редиректами, hreflang. Если сигналы противоречат друг другу, поисковик выберет тот адрес, который сочтёт правильным, а ваш canonical проигнорирует. Это описано в официальной документации Google по консолидации дублей.
Из этого следует всё остальное: canonical работает не сам по себе, а только когда остальные сигналы указывают туда же.
Синтаксис
Тег ставится в <head>:
<link rel="canonical" href="https://example.com/stranica">
Три правила, которые нарушают чаще всего:
Адрес абсолютный. Относительные пути формально допустимы, но любая ошибка в базовом URL превращает их в мусор. Пишите полностью, вместе со схемой и доменом.
Тег ровно один. Две разные canonical-ссылки на странице — и Google отбросит обе. Это типичный результат работы двух SEO-плагинов одновременно.
Только в <head>. Canonical, оказавшийся в <body> — например, вставленный скриптом в неудачное место, — не учитывается.
Для файлов, у которых нет HTML-кода (PDF, изображения), canonical передаётся HTTP-заголовком:
Link: <https://example.com/document.pdf>; rel="canonical"
Что canonical решает
Одна задача: у одного и того же содержимого несколько адресов, и все они должны остаться доступными.
Типичные случаи:
- параметры сортировки и фильтров:
?sort=price,?color=red; - UTM-метки и рекламные идентификаторы;
- один товар в нескольких категориях;
- версии для печати;
- один материал на разных поддоменах.
Во всех этих случаях страницу нельзя закрыть редиректом — она нужна пользователю. Canonical говорит поисковику, какой из адресов считать основным, и объединяет сигналы на нём.
Canonical на себя
Страница может указывать canonical на саму себя. Это не обязательно, но полезно: так вы страхуетесь от того, что кто-то откроет ваш адрес с чужой меткой в конце и поисковик сочтёт его отдельной страницей.
Чем canonical не является
Здесь ошибаются чаще всего, поэтому разберём соседние инструменты в одной таблице.
| Задача | Инструмент | Почему не canonical |
|---|---|---|
| Страница переехала навсегда | Редирект 301 | Canonical оставит старый адрес доступным |
| Адрес меняется временно | Редирект 302 | То же самое |
| Страница не должна быть в индексе | noindex |
Canonical не удаляет из индекса |
| Страницу не надо сканировать | robots.txt | Но это не выводит её из индекса |
| Одно содержимое на разных языках | hreflang + canonical на себя | Это не дубли |
| Постраничная навигация | Ничего | Страницы 2, 3, 4 самостоятельны |
Два пункта заслуживают отдельного внимания.
Canonical не заменяет 301. Если страница действительно переехала, нужен редирект. Canonical — для ситуаций, когда обе страницы должны работать.
Постраничная навигация — не дубли. Указывать canonical со всех страниц списка на первую — распространённая ошибка: содержимое страниц 2 и 3 отличается, и вы просто убираете его из индекса.
Canonical и hreflang
Самая тонкая часть, и здесь же живёт ошибка, которая стоит дороже всех остальных.
Ошибка: канонизировать все языковые версии на английскую. Логика кажется разумной — «английская главная». Результат противоположный: вы сообщаете поисковику, что немецкая и испанская версии не самостоятельны, и они выпадают из выдачи в своих странах.
Правильная схема:
- каждая языковая версия указывает canonical на себя;
- все версии перечисляют друг друга через
hreflang, включая саму себя; - связи взаимны: если A ссылается на B, то B обязан ссылаться на A;
hreflangведёт на канонические адреса, а не на варианты с параметрами;x-defaultуказывает версию для тех, чей язык не подошёл ни к одной.
Так это устроено на сайте, который вы сейчас читаете. У страницы про сокращение ссылок YouTube есть 21 языковая версия, и каждая канонизируется сама на себя. Китайская выглядит так:
<link rel="canonical" href="https://lix.li/suoduan-youtube-lianjie">
<link rel="alternate" hreflang="en" href="https://lix.li/shorten-youtube-link">
<link rel="alternate" hreflang="zh" href="https://lix.li/suoduan-youtube-lianjie">
<link rel="alternate" hreflang="es" href="https://lix.li/acortar-link-youtube">
Обратите внимание: canonical ведёт на китайский адрес, а не на английский, и китайская версия присутствует в собственном списке hreflang.
Частые ошибки
Google собрал основные ещё в заметке о пяти ошибках с rel=canonical, и за годы список почти не изменился.
Canonical на страницу, которая отдаёт 404. Тег будет проигнорирован целиком.
Canonical на страницу с noindex. Противоречивые сигналы: вы одновременно говорите «считай главной эту» и «не индексируй её».
Canonical на адрес, закрытый в robots.txt. Поисковик не может его проверить, поэтому не может и подтвердить.
Цепочки. A указывает на B, B на C. В Search Console это превращается в «канонический адрес не выбран». Указывайте сразу на конечный адрес.
Смешение http и https, www и без www. Схема и хост в canonical должны совпадать с той версией сайта, которую вы считаете основной.
Canonical и noindex на одной странице. Выберите что-то одно.
Когда Google выбрал другой адрес
В Search Console это отчёт «Страница является копией. Google выбрал другой канонический URL, чем пользователь».
Это не ошибка разметки и не наказание. Это сообщение о том, что остальные сигналы перевесили ваш тег. Что проверить:
- Внутренние ссылки. Если весь сайт ссылается на вариант с параметром, а canonical указывает на чистый адрес, поисковик поверит ссылкам.
- Карту сайта. В ней должны быть только канонические адреса.
- Редиректы. Если canonical указывает на адрес, который сам куда-то редиректит, тег обесценивается.
- Действительно ли это дубли. Если содержимое различается заметно, поисковик справедливо сочтёт страницы разными.
Согласуйте сигналы — и тег заработает. Спорить с алгоритмом бесполезно, он читает всю картину целиком.
Короткие ссылки и canonical
Вопрос, который задают часто и на который общие руководства не отвечают.
Создаёт ли короткая ссылка дубль страницы? Нет.
Сокращатель не отдаёт копию содержимого — он возвращает HTTP-редирект. У ответа с кодом 302 нет тела и нет <head>, поэтому в нём физически негде разместить canonical. Поисковик проходит редирект насквозь и работает с конечным адресом, у которого свой canonical. Как устроен этот механизм, разобрано в статье про то, как работают сокращатели ссылок.
Короткие ссылки на этом сайте дополнительно отдают заголовок X-Robots-Tag: noindex, nofollow, то есть прямо просят не индексировать сам редирект.
А свой короткий домен? Тоже не создаёт дублей, пока он редиректит. Дубли появляются, если вы отдаёте одно и то же содержимое на двух доменах без редиректа — вот тогда нужен canonical на основной. О том, зачем вообще нужен собственный домен для коротких ссылок, написано отдельно, а подключить его можно на странице своего домена.
Короткий чек-лист
- Один canonical на страницу, в
<head>, с абсолютным адресом. - Целевая страница отдаёт 200, не закрыта в robots.txt и не помечена
noindex. - Никаких цепочек — сразу конечный адрес.
- Каждая языковая версия канонизируется на себя, hreflang взаимен.
- Карта сайта и внутренние ссылки ведут на те же канонические адреса.
- Постраничная навигация и переехавшие страницы решаются не canonical, а собственными средствами.