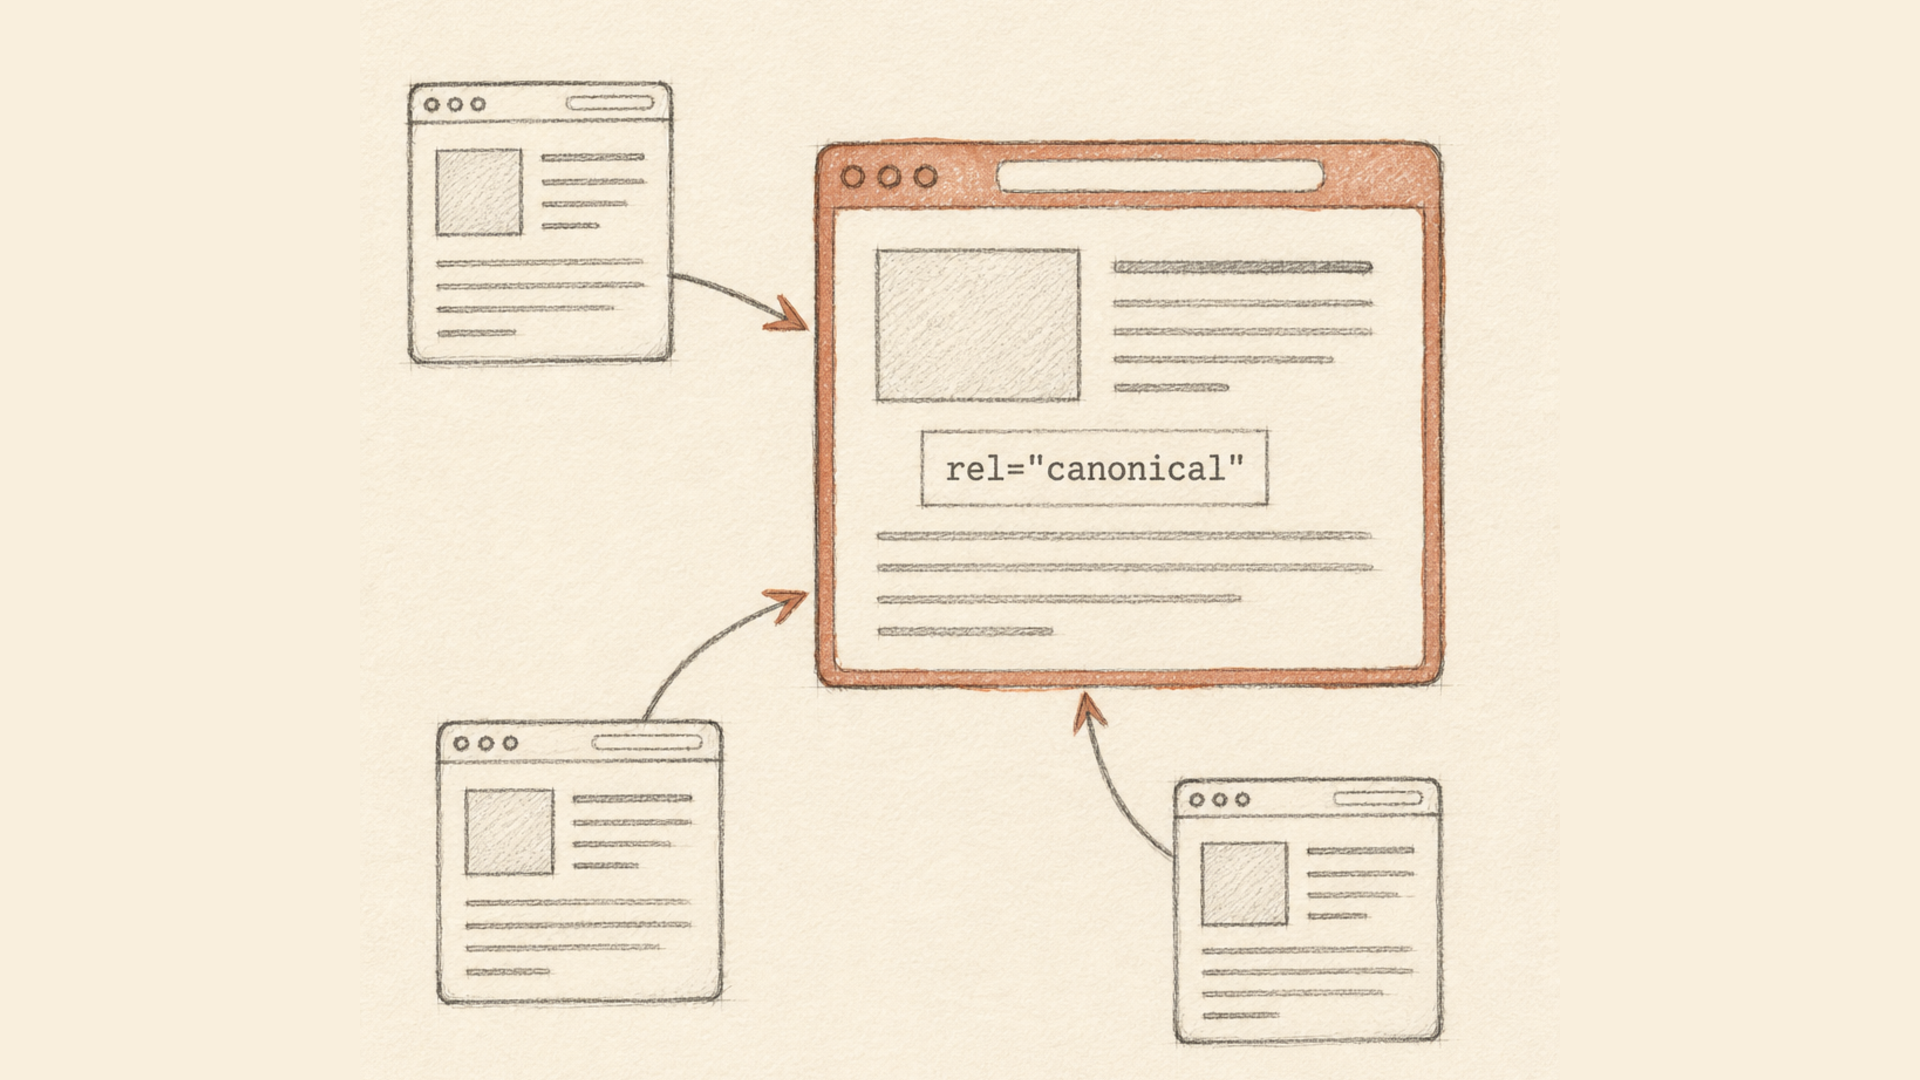
Začněme faktem, který převrací polovinu představ o tomto tagu: rel="canonical" je nápověda, nikoli příkaz.
Google jej poměřuje se všemi ostatními signály: interním prolinkováním, mapou webu, přesměrováními, hreflangem. Když si tyto signály odporují, vyhledávač zvolí adresu, kterou považuje za správnou, a váš canonical ignoruje. Je to uvedeno v oficiální dokumentaci Googlu ke konsolidaci duplicitních URL.
Všechno ostatní z toho plyne: canonical nefunguje sám o sobě, ale jen tehdy, když ostatní signály míří stejným směrem.
Syntaxe
Tag patří do <head>:
<link rel="canonical" href="https://example.com/stranka">
Tři pravidla, která se porušují nejčastěji:
Používejte absolutní URL. Relativní cesty jsou technicky přípustné, ale jakákoli chyba v základní URL z nich udělá nesmysl. Napište ji celou, včetně schématu a domény.
Přesně jeden tag. Dva různé odkazy canonical na jedné stránce a Google zahodí oba. Je to klasický výsledek dvou současně běžících SEO pluginů.
Jen uvnitř <head>. Canonical, který skončí v <body> — třeba vložený skriptem na špatné místo —, se nezapočítává.
U souborů bez vlastního HTML (PDF, obrázky) se canonical posílá jako HTTP hlavička:
Link: <https://example.com/dokument.pdf>; rel="canonical"
Co canonical řeší
Jediný problém: stejný obsah leží na několika URL a všechny musí zůstat dostupné.
Typické případy:
- parametry řazení a filtrů:
?sort=price,?color=red; - UTM značky a reklamní identifikátory;
- jeden produkt zařazený ve více kategoriích;
- verze pro tisk;
- stejný materiál na různých subdoménách.
V žádném z nich nelze prostě přesměrovat — stránka je potřeba. Canonical vyhledávači sděluje, kterou adresu považovat za hlavní, a slučuje na ni signály.
Canonical na sebe sama
Stránka může svůj canonical mířit na sebe samu. Není to povinné, ale je to užitečné: pojistí vás to pro případ, že někdo otevře vaši adresu s cizím parametrem na konci a vyhledávač ji vezme jako samostatnou stránku.
Čím canonical není
Tady vzniká většina chyb, proto sousední nástroje v jedné tabulce.
| Cíl | Nástroj | Proč ne canonical |
|---|---|---|
| Stránka se trvale přestěhovala | Přesměrování 301 | Canonical nechá starou adresu dostupnou |
| Cíl se mění dočasně | Přesměrování 302 | Stejný důvod |
| Stránka nemá být v indexu | noindex |
Canonical z indexu nic neodstraňuje |
| Stránka nemá být procházena | robots.txt | Což ji z indexu také nevyjme |
| Stejný obsah v několika jazycích | hreflang + canonical na sebe | To nejsou duplicity |
| Stránkované výpisy | Nic | Stránky 2, 3, 4 stojí samy o sobě |
Dva body si zaslouží důraz.
Canonical nenahrazuje 301. Pokud se stránka skutečně přestěhovala, přesměrujte. Canonical je pro situace, kdy obě adresy musí dál fungovat.
Stránkování není duplicita. Mířit canonical všech stránek výpisu na první je běžná chyba: obsah stránek 2 a 3 se liší a vy jej jednoduše odstraňujete z indexu.
Canonical a hreflang
Nejjemnější část a zároveň místo, kde bydlí nejdražší chyba celé oblasti.
Ta chyba: kanonizovat všechny jazykové verze na anglickou. Logika působí rozumně — angličtina je «hlavní» verze. Výsledek je opačný: sdělujete vyhledávači, že německá a španělská stránka nejsou samostatné, a ony zmizí z výsledků na vlastních trzích.
Správné uspořádání:
- každá jazyková verze míří svůj canonical na sebe samu;
- všechny verze se navzájem uvádějí přes
hreflang, včetně sebe; - vztahy jsou vzájemné: pokud A odkazuje na B, musí B odkazovat na A;
hreflangmíří na kanonické URL, nikoli na varianty s parametry;x-defaultoznačuje záložní verzi pro návštěvníky, jejichž jazyk neodpovídá žádné.
Přesně tak je postaven web, který právě čtete. Stránka o zkracování odkazů na YouTube existuje ve 21 jazykových verzích a každá kanonizuje sama na sebe. Čínská vypadá takto:
<link rel="canonical" href="https://lix.li/suoduan-youtube-lianjie">
<link rel="alternate" hreflang="en" href="https://lix.li/shorten-youtube-link">
<link rel="alternate" hreflang="zh" href="https://lix.li/suoduan-youtube-lianjie">
<link rel="alternate" hreflang="es" href="https://lix.li/acortar-link-youtube">
Všimněte si, že canonical míří na čínskou adresu, nikoli na anglickou, a že čínská verze figuruje ve vlastním seznamu hreflang.
Časté chyby
Google ty hlavní sesbíral už před lety v poznámce o pěti chybách s rel=canonical a seznam se od té doby téměř nezměnil.
Canonical míří na URL, která vrací 404. Tag bude zcela ignorován.
Canonical míří na stránku s noindex. Protichůdné signály: říkáte současně «považuj tuto za hlavní» a «neindexuj ji».
Canonical míří na URL blokovanou v robots.txt. Robot ji nemůže stáhnout, takže ji ani nemůže potvrdit.
Řetězce. A míří na B, B na C. V Search Console se z toho stane «kanonická adresa nebyla vybrána». Miřte rovnou na konečnou URL.
Míchání http a https, www a bez www. Schéma a host v canonicalu musí odpovídat verzi webu, kterou považujete za hlavní.
Canonical a noindex na téže stránce. Vyberte si jedno.
Když Google zvolí jinou adresu
V Search Console se to zobrazí jako «Duplicita, Google zvolil jinou kanonickou stránku než uživatel».
Není to chyba značkování ani trest. Je to zpráva, že ostatní signály převážily váš tag. Co zkontrolovat:
- Interní odkazy. Pokud celý web odkazuje na variantu s parametrem, zatímco canonical míří na čistou adresu, vyhledávač uvěří odkazům.
- Mapu webu. Měla by obsahovat výhradně kanonické adresy.
- Přesměrování. Pokud canonical míří na adresu, která sama někam přesměrovává, tag ztrácí sílu.
- Zda to opravdu jsou duplicity. Liší-li se obsah znatelně, vyhledávač právem považuje stránky za odlišné.
Srovnejte signály a tag začne fungovat. Přít se s algoritmem nemá smysl; čte celý obraz.
Krátké odkazy a canonical
Otázka, která padá často a na kterou obecné návody neodpovídají.
Vytváří krátký odkaz duplicitu stránky? Ne.
Zkracovač neposílá kopii obsahu — vrací HTTP přesměrování. Odpověď 302 nemá tělo ani <head>, takže fyzicky není kam canonical umístit. Robot přesměrování projde a pracuje s cílem, který nese vlastní canonical. Jak tento mechanismus funguje, popisuje článek o tom, jak fungují zkracovače odkazů.
Krátké odkazy na tomto webu navíc vracejí hlavičku X-Robots-Tag: noindex, nofollow, čímž výslovně žádají, aby samotné přesměrování nebylo indexováno.
A vlastní krátká doména? Ta duplicity také nevytváří, dokud přesměrovává. Duplicity vznikají, když stejný obsah servírujete na dvou doménách bez přesměrování — právě tehdy je potřeba canonical na tu hlavní. Připojit si ji můžete na stránce vlastní domény.
Krátký kontrolní seznam
- Jeden canonical na stránku, uvnitř
<head>, s absolutní URL. - Cíl vrací 200, není blokován v robots.txt ani označen
noindex. - Žádné řetězce — mířit rovnou na konečnou URL.
- Každá jazyková verze kanonizuje sama na sebe; hreflang je vzájemný.
- Mapa webu a interní odkazy vedou na tytéž kanonické adresy.
- Stránkování a přestěhované stránky se řeší vlastními nástroji, ne canonicalem.