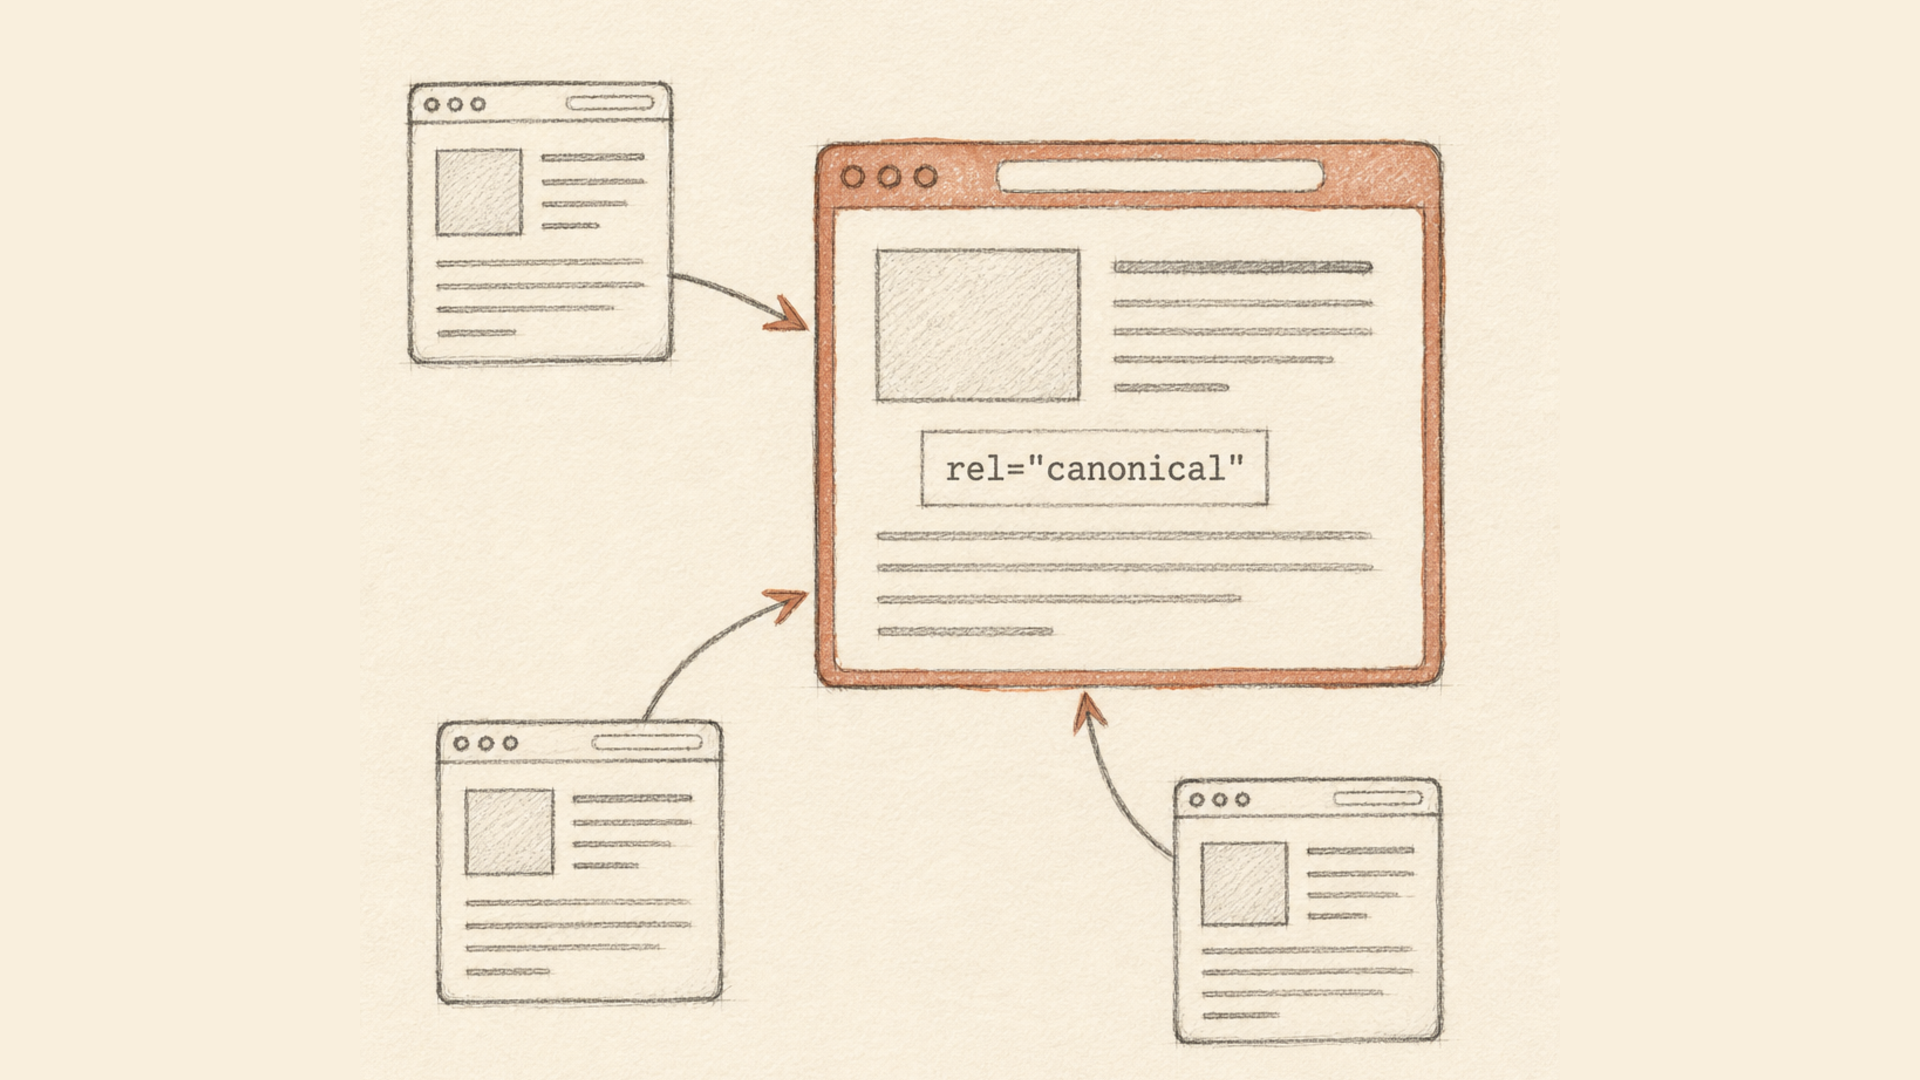
เริ่มจากข้อเท็จจริงที่พลิกความเข้าใจครึ่งหนึ่งเกี่ยวกับแท็กนี้: rel="canonical" คือคำใบ้ ไม่ใช่คำสั่ง
Google ชั่งน้ำหนักมันร่วมกับสัญญาณอื่นทั้งหมด ได้แก่ ลิงก์ภายใน แผนผังเว็บไซต์ การรีไดเรกต์ และ hreflang เมื่อสัญญาณเหล่านี้ขัดแย้งกัน เครื่องมือค้นหาจะเลือก URL ที่มันเห็นว่าถูกต้องและเพิกเฉยต่อ canonical ของคุณ เรื่องนี้ระบุไว้ในเอกสารทางการของ Google เรื่องการรวม URL ที่ซ้ำกัน
ทุกอย่างที่เหลือตามมาจากข้อนี้: canonical ไม่ทำงานโดยลำพัง แต่ทำงานก็ต่อเมื่อสัญญาณอื่นชี้ไปทางเดียวกัน
ไวยากรณ์
แท็กวางไว้ใน <head>:
<link rel="canonical" href="https://example.com/page">
สามกฎที่ถูกละเมิดบ่อยที่สุด:
ใช้ URL แบบเต็ม เส้นทางแบบสัมพัทธ์อนุญาตในทางเทคนิค แต่ความผิดพลาดใด ๆ ใน URL ฐานจะทำให้มันไร้ค่า เขียนให้ครบทั้งโปรโตคอลและโดเมน
มีแท็กเดียวเท่านั้น ถ้าในหน้าเดียวมี canonical สองอันที่ต่างกัน Google จะทิ้งทั้งสองอัน นี่คือผลลัพธ์คลาสสิกของการเปิดใช้ปลั๊กอิน SEO สองตัวพร้อมกัน
อยู่ใน <head> เท่านั้น canonical ที่ไปตกอยู่ใน <body> เช่นถูกสคริปต์แทรกผิดที่ จะไม่ถูกนับ
สำหรับไฟล์ที่ไม่มี HTML ของตัวเอง (PDF รูปภาพ) canonical ส่งผ่านส่วนหัว HTTP:
Link: <https://example.com/document.pdf>; rel="canonical"
canonical แก้ปัญหาอะไร
แก้ปัญหาเดียว: เนื้อหาเดียวกันอยู่ที่หลาย URL และทุก URL ต้องยังเข้าถึงได้
กรณีทั่วไป:
- พารามิเตอร์การเรียงลำดับและตัวกรอง:
?sort=price,?color=red; - แท็ก UTM และตัวระบุโฆษณา;
- สินค้าชิ้นเดียวที่อยู่ในหลายหมวดหมู่;
- หน้าสำหรับพิมพ์;
- เนื้อหาเดียวกันบนซับโดเมนต่างกัน
ไม่มีกรณีใดที่คุณจะรีไดเรกต์ทิ้งได้ เพราะหน้านั้นยังจำเป็น canonical บอกเครื่องมือค้นหาว่าให้ถือที่อยู่ใดเป็นหลัก และรวบรวมสัญญาณไว้ที่นั่น
canonical ที่ชี้มาที่ตัวเอง
หน้าเว็บสามารถชี้ canonical มาที่ตัวเองได้ ไม่บังคับแต่มีประโยชน์ เพราะช่วยกันกรณีที่มีคนเปิด URL ของคุณโดยมีพารามิเตอร์แปลกปลอมต่อท้าย แล้วเครื่องมือค้นหาถือว่าเป็นหน้าแยกต่างหาก
canonical ไม่ใช่อะไร
ข้อผิดพลาดส่วนใหญ่อยู่ตรงนี้ จึงขอวางเครื่องมือข้างเคียงไว้ในตารางเดียว
| เป้าหมาย | เครื่องมือ | ทำไมไม่ใช่ canonical |
|---|---|---|
| หน้าย้ายถาวรแล้ว | รีไดเรกต์ 301 | canonical ยังปล่อยให้ที่อยู่เดิมเข้าถึงได้ |
| ปลายทางเปลี่ยนชั่วคราว | รีไดเรกต์ 302 | เหตุผลเดียวกัน |
| หน้าไม่ควรอยู่ในดัชนี | noindex |
canonical ไม่ได้ลบอะไรออกจากดัชนี |
| หน้าไม่ควรถูกรวบรวมข้อมูล | robots.txt | ซึ่งก็ไม่ได้เอาออกจากดัชนีเช่นกัน |
| เนื้อหาเดียวกันหลายภาษา | hreflang + canonical มาที่ตัวเอง | สิ่งเหล่านี้ไม่ใช่หน้าซ้ำ |
| รายการแบบแบ่งหน้า | ไม่ต้องใช้อะไร | หน้า 2, 3, 4 ยืนอยู่ได้ด้วยตัวเอง |
สองรายการควรเน้นเป็นพิเศษ
canonical ไม่ได้แทนที่ 301 ถ้าหน้าย้ายจริง ให้รีไดเรกต์ canonical มีไว้สำหรับกรณีที่ทั้งสอง URL ต้องทำงานต่อไป
การแบ่งหน้าไม่ใช่การซ้ำ การชี้ canonical ของทุกหน้าในรายการไปที่หน้าแรกเป็นข้อผิดพลาดที่พบบ่อย เนื้อหาของหน้า 2 และ 3 ต่างกัน และคุณกำลังลบมันออกจากดัชนีเฉย ๆ
canonical กับ hreflang
ส่วนที่ละเอียดอ่อนที่สุด และเป็นที่อยู่ของข้อผิดพลาดที่แพงที่สุดในเรื่องนี้
ข้อผิดพลาดนั้นคือ การทำ canonical ทุกเวอร์ชันภาษาไปที่เวอร์ชันภาษาอังกฤษ ตรรกะดูสมเหตุสมผล เพราะภาษาอังกฤษคือเวอร์ชัน «หลัก» ผลลัพธ์กลับตรงกันข้าม คุณกำลังบอกเครื่องมือค้นหาว่าหน้าภาษาเยอรมันและสเปนไม่เป็นอิสระ และหน้าเหล่านั้นจะหายไปจากผลการค้นหาในตลาดของตัวเอง
โครงสร้างที่ถูกต้อง:
- แต่ละเวอร์ชันภาษาชี้ canonical มาที่ตัวเอง;
- ทุกเวอร์ชันระบุถึงกันและกันผ่าน
hreflangรวมถึงตัวเองด้วย; - ความสัมพันธ์ต้องเป็นสองทาง: ถ้า A อ้างถึง B แล้ว B ต้องอ้างถึง A;
hreflangชี้ไปยัง URL แบบ canonical ไม่ใช่รูปแบบที่มีพารามิเตอร์;x-defaultระบุเวอร์ชันสำรองสำหรับผู้เข้าชมที่ภาษาไม่ตรงกับอันใดเลย
เว็บไซต์ที่คุณกำลังอ่านอยู่นี้สร้างขึ้นแบบนั้น หน้าเกี่ยวกับการย่อลิงก์ YouTube มี 21 เวอร์ชันภาษา และแต่ละเวอร์ชันทำ canonical มาที่ตัวเอง เวอร์ชันภาษาจีนเป็นแบบนี้:
<link rel="canonical" href="https://lix.li/suoduan-youtube-lianjie">
<link rel="alternate" hreflang="en" href="https://lix.li/shorten-youtube-link">
<link rel="alternate" hreflang="zh" href="https://lix.li/suoduan-youtube-lianjie">
<link rel="alternate" hreflang="es" href="https://lix.li/acortar-link-youtube">
สังเกตว่า canonical ชี้ไปยัง URL ภาษาจีน ไม่ใช่ภาษาอังกฤษ และเวอร์ชันภาษาจีนปรากฏอยู่ในรายการ hreflang ของตัวเอง
ข้อผิดพลาดที่พบบ่อย
Google รวบรวมข้อสำคัญไว้ตั้งแต่หลายปีก่อนในบันทึกเรื่องห้าข้อผิดพลาดกับ rel=canonical และรายการนั้นแทบไม่เปลี่ยนแปลงเลย
canonical ชี้ไปยัง URL ที่คืนค่า 404 แท็กจะถูกเพิกเฉยทั้งหมด
canonical ชี้ไปยังหน้าที่มี noindex สัญญาณขัดแย้งกัน คุณกำลังบอกพร้อมกันว่า «ถือหน้านี้เป็นหลัก» และ «อย่าจัดทำดัชนีหน้านี้»
canonical ชี้ไปยัง URL ที่ถูกบล็อกใน robots.txt โปรแกรมรวบรวมข้อมูลดึงมันไม่ได้ จึงยืนยันไม่ได้เช่นกัน
ห่วงโซ่ A ชี้ไป B, B ชี้ไป C ใน Search Console จะกลายเป็น «ไม่ได้เลือก URL ตามรูปแบบบัญญัติ» ให้ชี้ไปยัง URL สุดท้ายโดยตรง
ปน http กับ https, www กับไม่มี www โปรโตคอลและโฮสต์ใน canonical ต้องตรงกับเวอร์ชันเว็บไซต์ที่คุณถือเป็นหลัก
canonical และ noindex บนหน้าเดียวกัน เลือกอย่างใดอย่างหนึ่ง
เมื่อ Google เลือก URL อื่น
ใน Search Console จะแสดงเป็น «ซ้ำกัน Google เลือก URL ตามรูปแบบบัญญัติที่ต่างจากผู้ใช้»
นี่ไม่ใช่ข้อผิดพลาดของมาร์กอัป และไม่ใช่บทลงโทษ มันคือข้อความบอกว่าสัญญาณอื่นมีน้ำหนักมากกว่าแท็กของคุณ สิ่งที่ควรตรวจสอบ:
- ลิงก์ภายใน ถ้าทั้งเว็บไซต์ลิงก์ไปยังรูปแบบที่มีพารามิเตอร์ ขณะที่ canonical ชี้ไปยัง URL ที่สะอาด เครื่องมือค้นหาจะเชื่อลิงก์
- แผนผังเว็บไซต์ ควรมีเฉพาะ URL แบบ canonical เท่านั้น
- การรีไดเรกต์ ถ้า canonical ชี้ไปยัง URL ที่ตัวมันเองรีไดเรกต์ต่อ แท็กจะหมดพลัง
- มันซ้ำกันจริงหรือไม่ ถ้าเนื้อหาต่างกันอย่างเห็นได้ชัด เครื่องมือค้นหาถูกต้องแล้วที่ถือว่าเป็นคนละหน้า
จัดสัญญาณให้ตรงกัน แล้วแท็กจะเริ่มทำงาน การเถียงกับอัลกอริทึมไม่มีประโยชน์ เพราะมันอ่านภาพรวมทั้งหมด
ลิงก์ย่อกับ canonical
คำถามที่ถูกถามบ่อย แต่คู่มือทั่วไปไม่ตอบ
ลิงก์ย่อสร้างหน้าซ้ำหรือไม่ ไม่
บริการย่อลิงก์ไม่ได้ส่งสำเนาเนื้อหา แต่คืนค่าการรีไดเรกต์ HTTP การตอบกลับแบบ 302 ไม่มีเนื้อความและไม่มี <head> จึงไม่มีที่ให้วาง canonical ในทางกายภาพ โปรแกรมรวบรวมข้อมูลจะตามรีไดเรกต์ไปและทำงานกับปลายทาง ซึ่งมี canonical ของตัวเอง
ลิงก์ย่อบนเว็บไซต์นี้ยังคืนค่าส่วนหัว X-Robots-Tag: noindex, nofollow เพิ่มเติม เพื่อขอโดยตรงว่าอย่าจัดทำดัชนีตัวรีไดเรกต์เอง
แล้วโดเมนย่อของตัวเองล่ะ ก็ไม่สร้างหน้าซ้ำเช่นกัน ตราบใดที่มันรีไดเรกต์ หน้าซ้ำจะเกิดขึ้นเมื่อคุณให้บริการเนื้อหาเดียวกันบนสองโดเมนโดยไม่รีไดเรกต์ นั่นแหละคือตอนที่ต้องใช้ canonical ชี้ไปยังโดเมนหลัก เหตุผลที่ควรมีโดเมนของตัวเองสำหรับลิงก์ย่อ มีอธิบายแยกไว้ และเชื่อมต่อได้ที่หน้าโดเมนของตัวเอง
เช็กลิสต์สั้น ๆ
- canonical หนึ่งอันต่อหนึ่งหน้า อยู่ใน
<head>เป็น URL แบบเต็ม - ปลายทางคืนค่า 200 ไม่ถูกบล็อกใน robots.txt และไม่มี
noindex - ไม่มีห่วงโซ่ — ชี้ไปยัง URL สุดท้ายโดยตรง
- แต่ละเวอร์ชันภาษาทำ canonical มาที่ตัวเอง และ hreflang เป็นสองทาง
- แผนผังเว็บไซต์และลิงก์ภายในนำไปยัง URL แบบ canonical ชุดเดียวกัน
- การแบ่งหน้าและหน้าที่ย้ายแล้ว แก้ด้วยเครื่องมือของมันเอง ไม่ใช่ด้วย canonical