Empecemos por el dato que echa abajo la mitad de las ideas sobre esta etiqueta: rel="canonical" es una sugerencia, no una orden.
Google la sopesa junto al resto de señales: enlaces internos, mapa del sitio, redirecciones, hreflang. Cuando esas señales se contradicen, el buscador elige la URL que considera correcta e ignora tu canonical. Está dicho en la documentación oficial de Google sobre consolidación de duplicados.
De ahí se deduce todo lo demás: canonical no funciona por sí solo, sino solo cuando las demás señales apuntan al mismo sitio.
Sintaxis
La etiqueta va en <head>:
<link rel="canonical" href="https://example.com/pagina">
Tres reglas que se incumplen con más frecuencia:
URL absoluta. Las rutas relativas están técnicamente permitidas, pero cualquier error en la URL base las convierte en basura. Escríbela completa, con esquema y dominio.
Exactamente una etiqueta. Dos enlaces canonical distintos en una página y Google descarta ambos. Es el resultado clásico de tener dos plugins de SEO activos a la vez.
Solo dentro de <head>. Un canonical que acaba en <body> —inyectado por un script en el sitio equivocado, por ejemplo— no cuenta.
Para archivos sin HTML propio (PDF, imágenes), el canonical viaja como cabecera HTTP:
Link: <https://example.com/documento.pdf>; rel="canonical"
Qué resuelve canonical
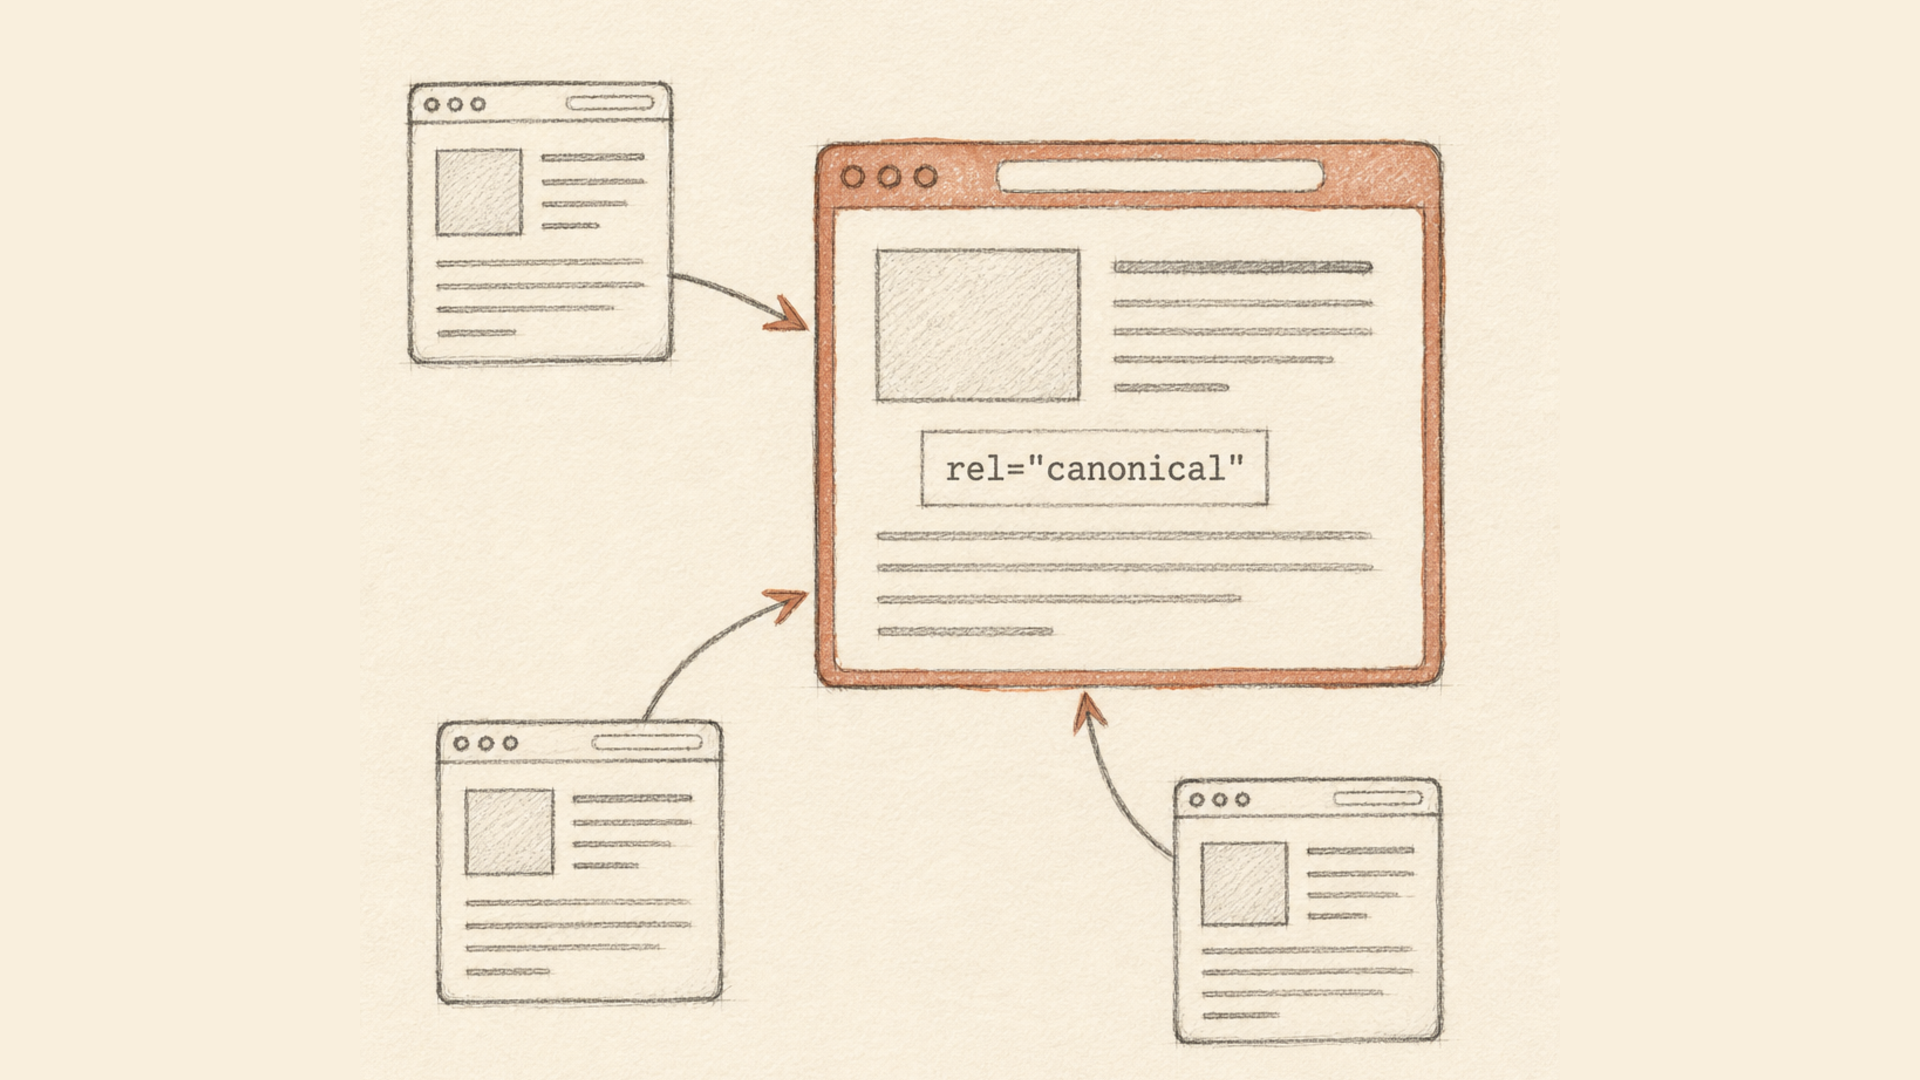
Un solo problema: el mismo contenido vive en varias URL y todas deben seguir accesibles.
Casos habituales:
- parámetros de orden y filtros:
?sort=price,?color=red; - etiquetas UTM e identificadores publicitarios;
- un producto listado en varias categorías;
- versiones para imprimir;
- el mismo material en subdominios distintos.
En ninguno de ellos puedes simplemente redirigir: la página hace falta. Canonical indica al buscador qué dirección tratar como principal y consolida las señales sobre ella.
Canonical hacia sí misma
Una página puede apuntar su canonical a sí misma. No es obligatorio, pero resulta útil: te protege de que alguien abra tu URL con un parámetro suelto añadido y el buscador la tome por una página distinta.
Qué no es canonical
Aquí está la mayoría de los errores, así que veamos las herramientas vecinas en una tabla.
| Objetivo | Herramienta | Por qué no canonical |
|---|---|---|
| La página se ha mudado definitivamente | Redirección 301 | Canonical deja la URL antigua accesible |
| El destino cambia temporalmente | Redirección 302 | Mismo motivo |
| La página no debe estar indexada | noindex |
Canonical no saca nada del índice |
| La página no debe rastrearse | robots.txt | Que tampoco la saca del índice |
| Mismo contenido en varios idiomas | hreflang + canonical propio | No son duplicados |
| Listados paginados | Nada | Las páginas 2, 3, 4 son autónomas |
Dos entradas merecen énfasis.
Canonical no sustituye a un 301. Si la página realmente se mudó, redirige. Canonical es para cuando ambas URL deben seguir funcionando.
La paginación no es duplicación. Apuntar el canonical de todas las páginas del listado a la primera es un error común: el contenido de las páginas 2 y 3 es distinto y lo estás sacando del índice sin más.
Canonical y hreflang
La parte más delicada, y donde vive el error más caro de esta área.
El error: canonicalizar todas las versiones de idioma hacia la inglesa. La lógica parece razonable: el inglés es la versión «principal». El resultado es el contrario: le dices al buscador que las páginas alemana y española no son independientes, y desaparecen de los resultados en sus propios mercados.
El esquema correcto:
- cada versión de idioma apunta su canonical a sí misma;
- todas las versiones se enumeran entre sí mediante
hreflang, incluyéndose a sí mismas; - las relaciones son recíprocas: si A referencia a B, B debe referenciar a A;
hreflangapunta a URL canónicas, no a variantes con parámetros;x-defaultseñala la versión de reserva para quien no encaje en ningún idioma.
Así está construido el sitio que estás leyendo. La página sobre acortar enlaces de YouTube existe en 21 versiones de idioma, y cada una se canonicaliza a sí misma. La china tiene este aspecto:
<link rel="canonical" href="https://lix.li/suoduan-youtube-lianjie">
<link rel="alternate" hreflang="en" href="https://lix.li/shorten-youtube-link">
<link rel="alternate" hreflang="zh" href="https://lix.li/suoduan-youtube-lianjie">
<link rel="alternate" hreflang="es" href="https://lix.li/acortar-link-youtube">
Fíjate en que el canonical apunta a la URL china y no a la inglesa, y en que la versión china figura en su propia lista de hreflang.
Errores frecuentes
Google catalogó los principales hace años en su nota sobre cinco errores con rel=canonical, y la lista apenas ha cambiado desde entonces.
Canonical apuntando a una URL que devuelve 404. La etiqueta se ignora por completo.
Canonical apuntando a una página con noindex. Señales contradictorias: dices «trata esta como principal» y «no la indexes» a la vez.
Canonical apuntando a una URL bloqueada en robots.txt. El rastreador no puede recuperarla, así que tampoco puede confirmarla.
Cadenas. A apunta a B, B apunta a C. En Search Console eso se convierte en «no se ha seleccionado ninguna URL canónica». Apunta directamente a la URL final.
Mezclar http con https, www con no-www. El esquema y el host del canonical deben coincidir con la versión del sitio que consideras principal.
Canonical y noindex en la misma página. Elige una de las dos.
Cuando Google elige otra URL
En Search Console aparece como «Duplicado: Google ha elegido una URL canónica diferente a la del usuario».
No es un error de marcado ni un castigo. Es un aviso de que las demás señales pesaron más que tu etiqueta. Qué revisar:
- Enlaces internos. Si todo el sitio enlaza a la variante con parámetro mientras el canonical apunta a la URL limpia, el buscador cree a los enlaces.
- El mapa del sitio. Debe contener únicamente URL canónicas.
- Redirecciones. Si el canonical apunta a una URL que a su vez redirige, la etiqueta pierde fuerza.
- Si de verdad son duplicados. Si el contenido difiere de forma apreciable, el buscador hace bien en tratarlas como páginas distintas.
Alinea las señales y la etiqueta empieza a funcionar. Discutir con el algoritmo no sirve: lee la imagen completa.
Enlaces cortos y canonical
Una pregunta que surge a menudo y que las guías generales no responden.
¿Un enlace acortado crea un duplicado de la página? No.
Un acortador no sirve una copia del contenido: devuelve una redirección HTTP. Una respuesta 302 no tiene cuerpo ni <head>, así que no hay físicamente dónde poner un canonical. El rastreador sigue la redirección y trabaja con el destino, que lleva su propio canonical. Cómo funciona ese mecanismo está explicado en cómo funcionan los acortadores de enlaces.
Los enlaces cortos de este sitio devuelven además la cabecera X-Robots-Tag: noindex, nofollow, pidiendo explícitamente que no se indexe la propia redirección.
¿Y un dominio corto propio? Tampoco crea duplicados mientras redirija. Los duplicados aparecen cuando sirves contenido idéntico en dos dominios sin redirigir: ahí sí hace falta un canonical apuntando al principal. Por qué conviene un dominio propio para enlaces cortos está tratado aparte, y puedes conectar uno en la página de dominio propio.
Lista de comprobación
- Un canonical por página, dentro de
<head>, con URL absoluta. - El destino devuelve 200, no está bloqueado en robots.txt ni marcado
noindex. - Sin cadenas: apunta directamente a la URL final.
- Cada versión de idioma se canonicaliza a sí misma; hreflang recíproco.
- Mapa del sitio y enlaces internos llevan a esas mismas URL canónicas.
- La paginación y las páginas mudadas se resuelven con sus propias herramientas, no con canonical.